
算力越强,功耗越克制:骁龙新一代旗舰平台的AI能效平衡术
过去的AI是“你问它才答”,芯片只需在用户触发时短暂响应;而智能体AI需要持续在线——持续感知环境、持续规划任务、持续调用工具。运行模式的改变,对芯片提出了一个硬性要求:必须在长时间内稳定输出性能,而不是运行片刻就因过热而降频。
骁龙新一代旗舰平台正是为满足智能体AI的核心硬件需求而打造。它的设计思路不是单纯追求算力峰值,而是在CPU、GPU、NPU三大核心模块上同步优化能效——用更少的电,让AI跑得更久。
CPU:智能体的“调度中枢”,省电从精准分配开始
高通在新一代Oryon CPU上的升级有一个细节:就是在亮眼的5GHz主频之外的独立时钟域。这一设计让每个核心可以单独进行频率扩展——刷微博时能效核低频运转,打开App时超大核单独拉升。需要多少给多少,不多给一度电。
配合FlexCache缓存架构,L2缓存被统一为所有核心共享的池子,核心需要的数据直接驻留,无需频繁访问系统内存。高通在博客中的表述很直接:FlexCache减少了核心访问系统内存的频率,即便在内存受限的情况下也能维持性能表现。对智能体而言,这意味着任务在核心之间流转时数据不丢失、不重载——每一次避免内存访问,都是一次功耗的节约。
GPU:AI成为功耗的减项,而不是加项
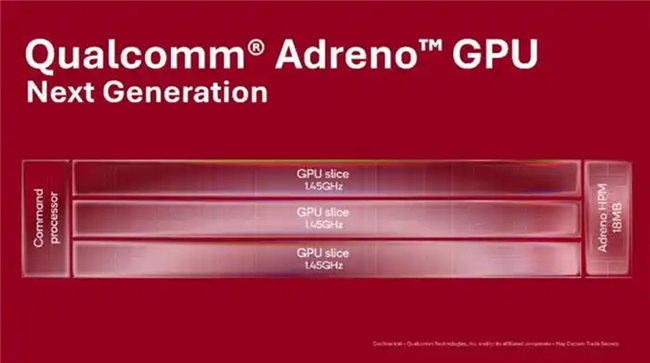
新一代Adreno GPU面临一个看似矛盾的任务:频率从1.2GHz提升至1.45GHz,但功耗要降下来。高通的做法是让AI帮忙省电。
18MB Adreno HPM片上高速显存让渲染过程中的中间数据直接存在片上,无需反复前往系统内存,带来约12%的功耗改善。Adreno Matrix Cores首次将AI专用矩阵核心引入GPU,神经网络计算不再需要离开图形渲染管线——每一段数据路径的缩短,都转化为功耗的节约。Adreno Neural Fusion将AI超分辨率和帧生成融入渲染流程,功耗相比上一代方案最高可节省40%。高通在博客中的定位很清楚:Adreno Neural Fusion的目标是“在呈现更高画质的同时,降低渲染开销和功耗”。
NPU:让大模型“住”进手机,也把功耗压下来
端侧大模型部署的最大瓶颈往往不是算力,而是内存带宽。模型生成答案时需要频繁读取KV缓存,片上空间不足就意味着数据要在NPU与主内存之间反复搬移,推高时延和功耗。
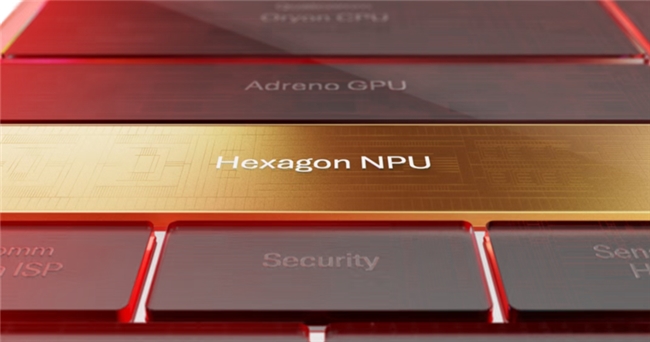
新一代Hexagon NPU将共享内存最高提升50%,让更多数据留存在NPU内部,减少对外部内存的访问。同时支持300亿参数的MoE模型,每次生成词元仅激活约30亿个被路由选中的参数——以低功耗和低内存需求实现大模型级别的AI体验。对于INT4精度模型,预填充性能提升最高50%。高通将新一代Hexagon NPU的定位概括为面向“始终运行的AI、长上下文推理、多模态模型、并发智能体以及低时延行动闭环”而设计。
三个模块,同一目标:让AI跑得更久
智能体AI给芯片出了一道难题:算力需求数量级跃升,运行模式从短暂响应变成持续在线,功耗压力前所未有。骁龙新一代旗舰平台的回答不是在某一个模块上堆料,而是在CPU、GPU、NPU三个层面同时做减法——独立时钟域减少无效算力,FlexCache减少内存访问,HPM减少数据搬运,共享内存扩容减少外部读取。
这些技术选择指向同一个判断:在智能体时代,能效不是性能的附属品,而是AI能力能否被真正用起来的前提。 当AI从问一句答一句进化到主动帮你做一连串事,芯片的价值不再由跑分峰值定义,而是由它在功耗红线之内能持续输出多少AI体验来定义。骁龙新一代旗舰平台正在做的,就是不仅让AI跑得快,还要跑得久。

