
当智能体走进数据中心,AMD EPYC如何支撑AI规模化部署?
如果某家企业的分析师要弄清楚一款产品为什么交付延误,或者核对一批库存和订单。他把这件事交给智能体,只用交代一句话即可。而系统后台要做的事远比这句话多:理解意图,找出相关数据,调用业务工具,必要时写一段代码跑一遍,检查计算结果,再把不同来源的信息整理成一份答复。

一句话进去,一份可交付的建议出来,中间隔着完整的执行过程。模型给出推理结果只是其中一段,数据查询、工具运行和结果校验都还在后面。数据放在哪里、多个任务怎么并发推进,直接决定用户等多久。所以当智能体进了企业,这些后台工作就落到基础设施头上。

2026年7月23日,AMD在旧金山举办Advancing AI 2026大会(简称AAI 2026),展示了AI解决方案与高性能计算上的最新进展。第六代AMD EPYC服务器处理器是其中重要的部分,它承担着以上工作流中一部分工作,既要支持智能体执行任务,又要运行智能体调用的企业服务。
智能体给CPU带来了什么工作
以前面的案例为例,如果一家企业想让智能体查找产品交付延误的原因,读取订单和查询库存可以分别进行,汇总原因却要等数据到齐;如果需要编写程序来核对结果,程序运行后还可能触发新一轮检索。一次业务请求会反复经过模型和工具,后台要处理的任务各不相同。
AMD此前分析过这类工作流程。请求进入系统后,需要检索上下文,经过规划和路由,再调用模型与工具,检查返回的结果。这些步骤有各自的计算要求,频繁运行代码的任务需要执行效率和并行资源,查询密集的任务还受内存与数据访问速度影响。CPU在其中承担了更多工作,即使模型推理足够快,工具或数据库的响应仍可能让整项任务停下来等待。

AMD将CPU在智能体工作流程中的任务分为智能体沙盒执行、AI主机节点和通用计算。沙盒中的CPU负责运行智能体及相关代码;AI主机节点为加速计算系统提供数据支持,比如给整套AI基础设施里的GPU供数据,AMD Helios机架级解决方案就属于这一层。至于数据库和存储等日常业务服务,则由通用计算资源承载。这也是智能体与企业已有服务器发生联系的地方,新的请求仍然要调用原来的业务系统。
第六代AMD EPYC,把处理器选择落到工作本身
智能体接手实际工作之后,服务器处理器的活更杂了,既要执行代码,协调工具调用,连接企业数据,还要给模型运行提供主机支持。AMD在AAI 2026上介绍的第六代EPYC 9006系列服务器处理器正是围绕这套需求推出的产品组合,其定位彼此错开。核心密度、频率、缓存、内存和能效,每一项取舍都落在具体的工作环节上。

EPYC 9006 SP7面向高密度智能体沙盒执行,最高支持256个核心、512条线程。它的高频配置也用于AI主机节点,最高频率可达5.0GHz,支持PCIe 6.0。AMD强调这款产品在CPU与GPU配合方面的改进,并以每瓦、每美元和每机架能够承载的智能体数量来描述其优势。
EPYC 9006 SP8则提供8至128核心可供选择,能够带来均衡的计算、内存和 I/O 以运行业务关键型应用、虚拟化及混合企业级工作负载,同时也适用于智能体AI 服务。

EPYC 9006X SP7面向高性能计算(HPC)、技术计算和数据密集型负载,吃的是高缓存与大内存带宽的红利。部分型号频率最高5.15 GHz,每核L3缓存容量是EPYC 9006 SP7的三倍,用来加速仿真、建模、大规模分析、数据检索这类内存吃紧的任务。
EPYC 9006 LP专为下一代机架级AI系统设计,同样扮演AI主机节点。它采用LPDDR内存,最高频率5.0 GHz,负责在加速器密集的机架里持续给加速器喂数据,部署规模从单个节点扩到AI工厂,系统利用率也随之线性增长。

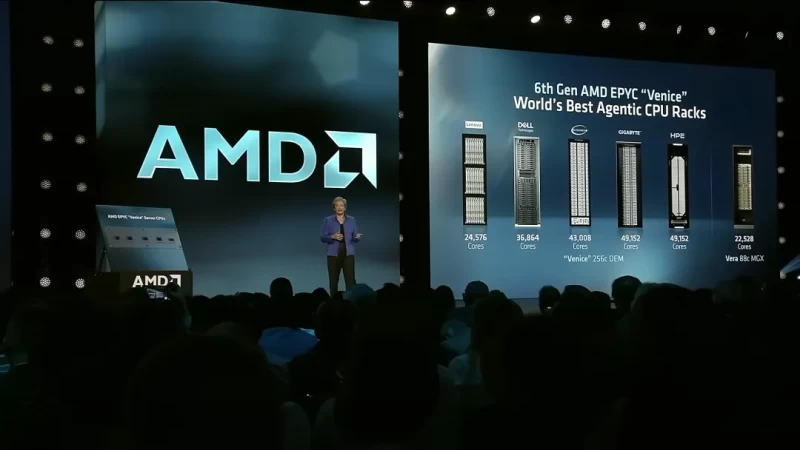
这些配置属于不同产品,不能拼成一颗处理器的规格。第六代EPYC服务器处理器的优势在于覆盖智能体工作的不同环节,客户可以按任务选择CPU。产品组合共享软件生态和安全基础,在同一架构体系下提供多种设计。智能体执行需要的密度与主机节点需要的频率和带宽各有侧重;技术计算还会关注缓存,企业服务则要考虑能效。第六代EPYC服务器处理器由此把新的应用需求落实到了处理器设计中,也为AI应用从试验转入持续运行提供了支持。
Meta与OpenAI怎样参与设计
在AAI 2026大会上,Meta披露的合作进展为EPYC的新一代能力提供了一个典型案例。AMD与Meta双方的合作已经跨越Milan、Bergamo和Turin等多代产品,Meta目前已经在基础设施中部署了数百万颗EPYC CPU,并作为Venice的先期客户参与合作。在AAI 2026大会期间,Meta正在实验室验证Venice平台,同时与AMD推进Verano及后续EPYC产品的合作。
这项合作还将为后续平台提供参考,包括AMD Instinct MI500加速器及下一代机架级系统。Meta有为数十亿人运营基础设施的经验,AMD则把客户要求与CPU、GPU和系统产品的规划结合起来。双方希望更快部署AI算力,并适应后续工作负载的变化。

在AAI 2026大会上,AMD还宣布与OpenAI在技术栈的各个层面上展开合作。根据AMD公布的消息,此次合作中,OpenAI将向AMD提供有关模型发展方向的早期洞察,而AMD则将其转化为芯片、系统和软件。据悉,OpenAI已经提前接触Helios系统,双方围绕硬件、软件和系统共同调试,并在Triton、Gluon、LLVM和ROCm等层面开展工作。模型演进带来的需求也会向后续基础设施设计反馈。
合作中的另一项进展是双方将研究如何使用AI来改善AI基础设施的软件开发,OpenAI预计从2026年第四季度开始让Helios上线,并在2027年加快部署,这标志着双方于2025年10月宣布的6吉瓦AMD GPU部署计划进入初期阶段。
从这些公开进展看,AMD的AI领导力有EPYC多代部署作为支撑,也在向软件与系统设计延伸。Meta的验证和OpenAI的共同调试使客户在平台开发期间就能提出要求,这与AMD在大会上强调的“要为不同的AI工作负载匹配合适的计算能力”理念相一致。
处理器之外的内存和网络
此外,数据供应也会限制计算。当任务增加时,计算与内存的需求未必同步增长。一组服务可能还有可用的计算资源,而内存容量却已经不足;另一组任务可能有足够容量,但频繁访问数据时需要等待。对于这一点,AMD显然也有前瞻布局。

6月15日,AMD发布收购MEXT的公告。MEXT开发了基于AI的预测式内存技术,旨在让闪存呈现更接近DRAM的使用特征,帮助扩展可用内存容量。AMD期待通过后续整合提高资源利用效率,降低客户的基础设施成本。这项技术将为AMD增加一种管理内存资源的办法,它能给服务器提供怎样的数据支持,仍要看后续整合。
当模型、数据库和工具服务分布在不同服务器上,任务还要等待数据在它们之间传递。CPU执行得更快之后,通信所用的时间仍会影响用户拿到结果的时间。7月20日,AMD宣布扩大与微软在Azure平台上的合作,范围涉及计算硬件,也包括网络及软件。微软将部署AMD Helios机架级解决方案,为自身和AI客户提供前沿模型推理能力,并支持Azure AI服务。
Azure还将新增两款基于AMD EPYC处理器的虚拟机系列,扩大Pensando DPU的部署范围,以支持Azure网络服务。按照当时公布的计划,AMD将于2026年下半年开始向包括微软在内的客户交付Helios。
物理AI与专用推理
AAI 2026发布的产品也覆盖了机器人。AMD推出Kria AI系列方案,其中的系统级模块采用锐龙AI Embedded X100系列处理器;机器人开发平台则整合CPU、GPU、NPU和FPGA计算,配套软件和参考设计,用于机器人及自主系统的开发与部署。

自适应计算在这里承担着面向现场设备的工作,机器人要考虑控制响应,也受功耗和环境条件限制。它与EPYC面向的数据中心任务各有侧重,共同扩展了AMD从训练到推理、从芯片到机架及现场设备的产品范围。

大会之后,AMD继续投入专用推理技术。8月6日,公司宣布签署收购Taalas的最终协议。Taalas专注于专用AI推理芯片,技术重点包括优化推理数据流。针对推理需求的进一步分化,AMD计划将相关技术纳入加速器路线,并发展系统级方案。
写在最后
AAI 2026前后,AMD的AI布局在产品发布与客户合作中持续推进,MEXT收购公告和Taalas收购协议则指向后续的技术整合。毫无疑问,第六代AMD EPYC服务器处理器是其中的重要支撑,它承担智能体沙盒执行、AI主机节点和企业通用计算的工作,将新的应用需求落实到CPU设计中,也让AI平台建设与企业已有的服务器环境接上了。
Meta的验证、微软Azure的部署规划以及OpenAI参与的共同调试让AMD在AI领域的领导力有了更具体的支撑。计算产品需要接受客户工作负载的检验,软件与系统也要在合作中不断调整。AMD正将这些工作纳入覆盖训练与推理的平台建设,产品范围从芯片延伸到机架和现场设备,推动AI从技术创新走向规模化部署。为不同的AI工作负载匹配合适的计算能力,这正是AMD在AAI 2026上强调的理念,也是这一系列产品与合作共同指向的目标。

