
跨越三“重”关:探索Agent AI时代算力重构之道
如果一场变革的迭代速度太快,人们往往会产生“今夕何夕”的困惑。此刻,Agent AI也许正在开启具有历史性意义的时间窗,算力基础设施的再次重构将驱动AI加速落地。
太阳底下无新事。纵观每一轮重大的技术革命,当其从基础设施投入建设期,迈向大规模应用普及阶段时,核心动力的底座都会急剧蜕变。
追溯第一次工业革命,蒸汽机逐步演化为集中式动力基础设施,与工厂体系深度结合,才释放出澎湃的生产力;再看第二次工业革命,电力作为通用基础设施全面铺开,流水线制造业方大行其道;到了第三次工业革命,客户机‑服务器架构打破大型主机的垄断,分布式集群日益兴起,终于迎来互联网、云计算的繁荣发展。
当下,肩负人工智能落地使命的Agent AI,同样对算力基础设施提出新的要求——智能体不再只是被动应答的工具,而是要主动执行各种任务,必须完成理解上下文、调用外部工具、处理数据、做出决策、触发行动等一系列环节,亟需算力底座全面提升综合能力,化解影响Agent顺畅运行的各种障碍。
显而易见,以算力堆叠为主、适配大模型训练的既有基础设施已无法应对Agent AI时代的严峻挑战,唯有跨
在不久前举办的AMD Advancing AI大会上,AMD不仅推出第六代EPYC处理器、Instinct MI400系列GPU、Helios机架级解决方案等重磅利器,而且展现出重构算力底座进化逻辑、建设AI基础设施全新生态的雄心与行动力,“每一类AI工作负载匹配最合适的算力”将成为Agent AI时代的最强音。
角色重估:CPU价值发现×GPU系统升级
底层基础设施的每一次重大蜕变,通常始自相关角色的价值重估。在AI变革初期,GPU凭借强大的并行计算能力更多承担AI模型训练与推理中的重要角色,CPU则为整个计算系统提供基础支撑。Agent AI的蓬勃兴起会带来新的变化,CPU与GPU之间的关系再平衡备受瞩目。
从角色分工的角度看,GPU主要为Agent AI提供强大的算力支撑,涵盖大模型训练与推理、AIGC应用等领域,其作用依然不可替代;CPU则更多承担智能体调度、工具调用、沙箱隔离、数据管理与业务编排等新型任务,这将决定Agent AI运转的顺畅程度与效率水平。
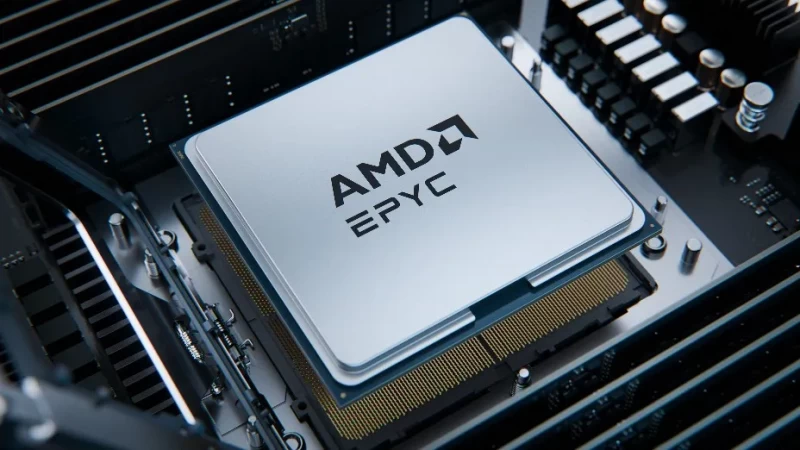
不难看出,CPU的角色定位逐步从边缘向中枢转变,做好Agent AI的“大管家”可谓任重而道远。AMD第六代EPYC处理器迎难而上,覆盖云计算、企业级、通用计算和高性能计算等几乎全部服务器工作负载类型,既可作为主机节点提供更高的速度与内存带宽,确保加速器持续获得数据供给、避免算力空转,又能为企业关键业务应用和AI辅助任务的高效运行保驾护航。
尤值一提的是,第六代EPYC正在重新定义Agent AI时代算力的“黄金标尺”:峰值算力不再只是最优先的选择标准,在同等功耗、成本和机架空间内,能否支撑起更多数量的智能体并行运行变得至关重要。依托领先的核心性能与线程密度,以及全场景渗透的强劲实力,第六代EPYC树立起CPU王者归来的示范标杆。
事实上,叙事逻辑的改变并不局限于CPU领域,伴随AI推理及行业应用迈向纵深,追求效率与成本的风潮也浸润到GPU的领地。业界逐渐意识到,单纯依靠通用型GPU覆盖所有推理场景并非最优解,秉承“术业有专攻”的新思路可能打开一片新天地。
收购是补齐拼图的有效路径。AMD深谙此道,其在今年8月初收购Taalas即是颇具借鉴意义的开创性举措。Taalas带来的专用推理芯片技术,高度契合特定场景对极致效率的要求,通过与AMD Instinct GPU进行系统级整合,将显著提升Agent AI时代GPU的系统化能力,为人工智能真正落地铺平道路。
版图重塑:全栈进化×软硬协同
知名学者刘易斯·芒福德在其著作《技术与文明》中指出,技术革命从来不是单一发明驱动,蒸汽机、电力的成功,高度依赖配套的基础设施网络、工艺流程协同演化,而非“英雄式的独角戏”。
从这个意义上讲,Agent AI要完成“惊险的一跳”,仅靠核心算力部件的快速进化尚不足够,还需要在网络、内存、软件等环节实现质的飞跃,进而驱动整个AI基础设施完成版图重塑和能力跃迁。
在前两次工业革命中,蒸汽机传动机械结构升级、输电线路配电网络优化带来的“连接”能力提升,都在先进技术落地进程中发挥了举足轻重的作用。Agent AI同样离不开网络层面的突破,AMD全新打造的Pensando Salina 400 DPU堪称开路先锋:借助400G超强吞吐能力,承担着前端、横向扩展和纵向扩展多种网络连接职责,解决了Agent需要在多个节点、多颗芯片之间频繁传递数据和指令的痛点,大幅改善AI系统的响应速度和拓展空间。
不容回避的是,Agent AI开疆扩土的力度越大,工作负载的规模与复杂度也会持续攀升,“内存墙”造成的瓶颈问题就愈发突出。AMD在今年6月完成对MEXT的收购,可基于“预测内存引擎”智能地将不常访问的“冷数据”迁移至成本更低的NAND闪存,同时预测并预加载即将需要的“热数据”至DRAM——在保持性能的同时扩展可用内存容量,有助于降低基础设施成本、提升资源利用率。
如果把AI基础设施比作建筑地基,那么除了“钢筋混凝土”等硬核能力外,还需构筑地基内部的预应力与张拉锚固体系,也就是要夯实“软件层”。在Advancing AI大会期间,AMD正式上线了ROCm.ai,旨在帮助开发者更快地构建、优化和部署AI开发环境;同时,ROCm.ai还能让Claude、Codex、Cursor等主流编程智能体原生理解AMD平台与ROCm软件栈,从而显著提升整个生态系统的开发效率。
生态重建:标杆引领×协作创新
面对Agent AI带来的诸多不确定性,以生态系统的合力完成突围,无疑是可践行的最优路径。对行业用户而言,尤为需要一整套已经完成协同设计、可以直接落地部署的完整系统,解决AI与业务深度融合的燃眉之急。
当然,这条路充满荆棘,既需要头部厂商的示范引领,也离不开生态系统的强强合作。AMD扮演了率先垂范的角色,其推出的Helios机架方案将高性能的第六代EPYC处理器、Instinct MI455X GPU整合在同一套架构之中,并通过AMD Pensando网络实现互联,由ROCm开放软件栈作为整套系统运转的底层驱动。
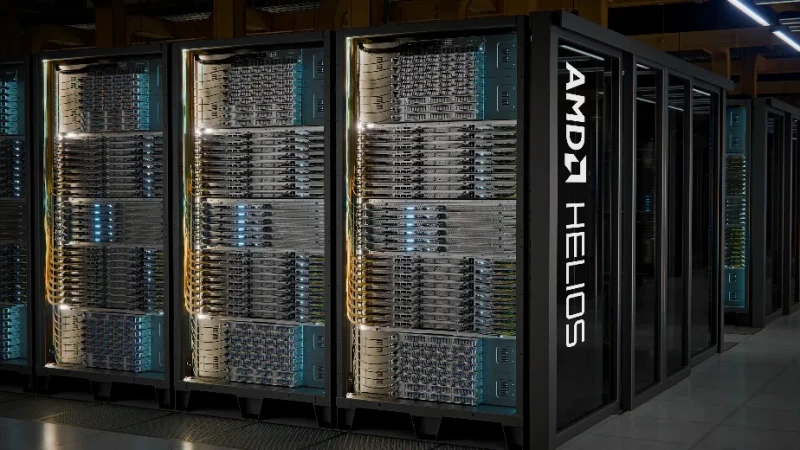
值得关注的是,这种从单芯片到机架一体化交付的模式,意味着客户不再需要自己去拼凑硬件或调试系统兼容性,而是可以直接获得整套经过端到端协同优化的基础设施单元,进而满足大规模推理、前沿模型训练和微调等多种场景的需求,从根本上解除了后顾之忧。
就像第一次工业革命中博尔顿与瓦特强强联合,打造索霍示范工厂,完整落地蒸汽动力全套系统;或如第二次工业革命中通用电气与福特共同进行工厂电气化系统性改造,开创独立电机驱动的流水线——AMD也通过与OpenAI和Meta等巨头的紧密合作,推动一体化交付模式落地生根。
种种迹象表明,全新的生态系统正在茁壮成长。AMD与OpenAI已从早期的产品层面协作演变为贯穿全栈的联合设计,双方工程团队围绕编译优化以及ROCm软件展开深度合作,并借助Codex等智能体工具辅助编写GPU代码,让性能改进沉淀为整个生态的通用能力;AMD与Meta的合作进一步彰显全栈协同的价值,通过共同设计覆盖Helios、EPYC、Pensando网络与ROCm的完整AI系统,助力大规模训练与推理更上层楼,为打造协同进化的新型合作模式奠定根基。
从角色重估到版图重塑再到生态重建,Agent AI时代的算力重构之道仍在路上。AMD及其伙伴们已踏上新的征程,越过无数山丘之后,下一座山的风景更值得期待。

