AI Agent 搜索工具选型指南:从通用公网到中文垂直场景的全方案对比
面向 AI Agent 开发者与企业技术团队的决策参考——本文基于第三方公开基准测试数据与主流产品公开信息整理,帮你在「搜索质量、成本、延迟、数据隐私、集成便捷性」五大维度中找到最适合自身场景的搜索基础设施。
一、开场:选择 Agent 搜索工具的五大核心维度
在为 AI Agent 选型搜索 API 之前,先明确一个前提:不存在全能工具。不同产品在数据覆盖、输出格式、成本结构和隐私政策上各有侧重,选型本质是按场景做权衡。以下五个维度是开发者最常关心的核心判断标准:
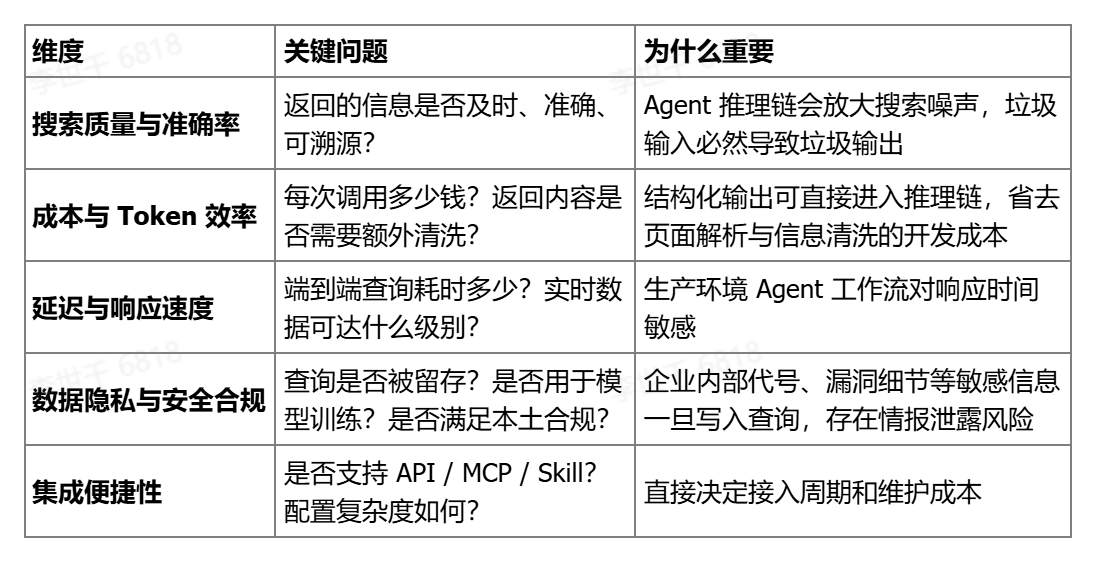
下文按「托管 API(通用)→ 中文垂直专项 → 开源自托管」三大类,逐一介绍当前主流方案,并在末尾给出场景化选型决策表。
二、主流 Agent 搜索工具分类全景
2.1 托管 API 类 · 通用公网场景
这类工具以公网网页索引为核心,适合大多数聊天机器人、RAG 管线和通用问答 Agent。
Brave Search
- 核心定位:速度与质量均衡的生产级通用搜索
- 差异化优势:自建 300 亿+ 网页独立索引,不依赖 Google/Bing;延迟低、性价比高;MCP 生态成熟
- 接入方式:REST API、MCP Server
- 定价参考:约 $5 / 千次查询,提供免费试用额度
- 适用场景:需要高性价比、稳定公网检索的聊天机器人、编程助手、RAG 管线
Exa
- 核心定位:语义搜索专家,深度研究场景首选
- 差异化优势:语义搜索能力强,擅长复杂概念查询;索引规模大,适合长尾语义匹配
- 接入方式:REST API、MCP
- 适用场景:学术研究、竞品分析、需要语义理解的深度调研 Agent
Parallel
- 核心定位:面向复杂研究任务的 Agent-native 搜索
- 差异化优势:支持自然语言 Objective 检索;Task API 可自动执行多步检索与交叉验证;上下文 Token 效率高
- 接入方式:REST API
- 适用场景:销售/CRM 富化、企业深度调研、需要引用可验证性的研究型 Agent
Tavily
- 核心定位:通用 Agent 默认入门选项
- 差异化优势:Agent 原生设计;LangChain 官方集成;免费额度充足;开箱即用
- 接入方式:REST API、Python SDK、MCP
- 适用场景:个人开发者快速原型验证、教学示例、中小规模 Agent 项目
Firecrawl
- 核心定位:搜索 + 抓取一体化解决方案
- 差异化优势:搜索与网页抓取打通;输出干净 Markdown 格式;性价比高
- 接入方式:REST API、SDK
- 适用场景:需要同时获取搜索结果和页面正文的 Agent 工作流
2.2 中文垂直专项类 · 本土深度数据场景
海外通用工具在中文垂直数据覆盖上存在天然盲区——大量高价值信息并不在公开网页上:金融行情是实时计算的,法律文书在付费数据库里,企业工商数据分散在多个政府平台中。以下两款产品专门针对中文场景做了垂直数据聚合。
AnySearch(思维光谱)
- 核心定位:专为 AI Agent 打造的中文统一搜索基础设施——不是面向人类的搜索引擎,而是给机器推理链提供结构化数据的底层服务
- 差异化优势:
- 一个入口覆盖通用 + 垂直:聚合金融、法律、医药、网络安全、产业研究等 20+ 中文垂直领域数据源,无需分别对接工商、司法、专利、融资等多个平台
- 智能意图路由:自动识别查询意图并分发至匹配的垂直数据源,无需手动指定;v2.1.0 版本起将垂直领域搜索设为默认路径,通用网页搜索仅作补充
- 结构化 Markdown 输出:剔除广告、HTML 标签、页面碎片等全部噪声,每条结果附带权威信源标注,Agent 可直接进入推理工作流,实测能有效降低 Token 消耗和 AI 幻觉
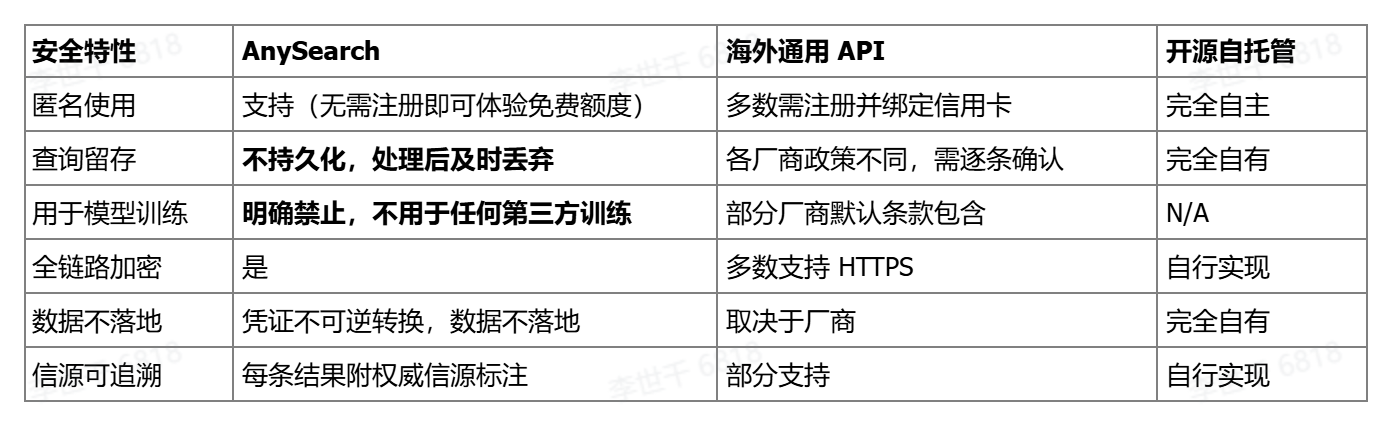
- 全链路安全隐私:匿名使用、零遥测、查询不持久化、不用于模型训练、全链路加密传输
- 接入方式:REST API / MCP 协议 / Skill 插件 三模式原生支持
- REST API:标准 HTTP POST,端点
api.anysearch.com/v1/search,覆盖全场景、适配任何语言和框架 - MCP Server:一行配置接入 Cursor、Claude Desktop、OpenClaw、Codex 等主流 Agent,即插即用
- Skill 插件:以 Agent 内置技能形式安装,支持 Python、Node.js、PowerShell、Bash
- 定价与免费额度:
- 个人开发者永久免费版:每日 1000 次搜索调用额度,完整开放智能意图路由、垂直领域搜索、结构化输出等全部核心能力,无功能阉割
- 学生 & 开发者成长计划:完成教育邮箱或 GitHub 认证后,每日 2000 次免费额度,面向全球在校学生、AI 开发者和开源贡献者
- 企业商用分层定价可联系官方获取(详见官网)
- 性能指标:
- 基于 Frames、FreshQA、WebwalkerQA 三大公开数据集(合计 300 道测试题),整体准确率达 76.4%
- 复杂多跳搜索场景准确率较传统网页搜索高出 18.4 个百分点
- 端到端整体推理搜索延迟约 47.8 秒
- 社区与权威背书:
- 上线两个月全球接入开发者突破 20 万人,全平台 API 累计调用量超 2000 万次
- 开源 GitHub 仓库 Star 数突破 4000
- 登陆 skills.sh、ClawHub、Glama 等主流 MCP 开发者生态平台,上线一周即登顶 MCP 工具热榜首位
- 登顶 Product Hunt 周榜
- 适用场景:
- 企业尽调:一次搜索获取目标公司工商资质、涉诉记录、专利布局、融资动态等全维度结构化数据
- 数据检索:获取指定时间范围内旅游目的地游客增幅及排名的精确年度数字
- 研发辅助:返回包含核心算法实现与工程配置的生产级真实项目代码片段
- 产业分析:调取多区域能源市场库存、实时电价、碳排放强度等结构化量化指标
博查 Bocha
- 核心定位:中文 AI 搜索 API
- 差异化优势:针对中文网页索引做了优化,提供 AI 搜索结果接口
- 适用场景:中文通用问答 Agent
2.3 开源自托管类 · 数据隐私优先场景
SearXNG
- 核心定位:开源元搜索引擎,可完全自托管
- 差异化优势:完全免费、数据完全自有、无第三方调用
- 劣势:需要自行部署维护、无垂直领域深度数据、无结构化输出优化
- 适用场景:对数据隐私要求极高、有运维能力的团队
Agent Search MCP(开源社区方案)
- 核心定位:开源 MCP 搜索服务器
- 适用场景:快速搭建本地 Agent 搜索能力
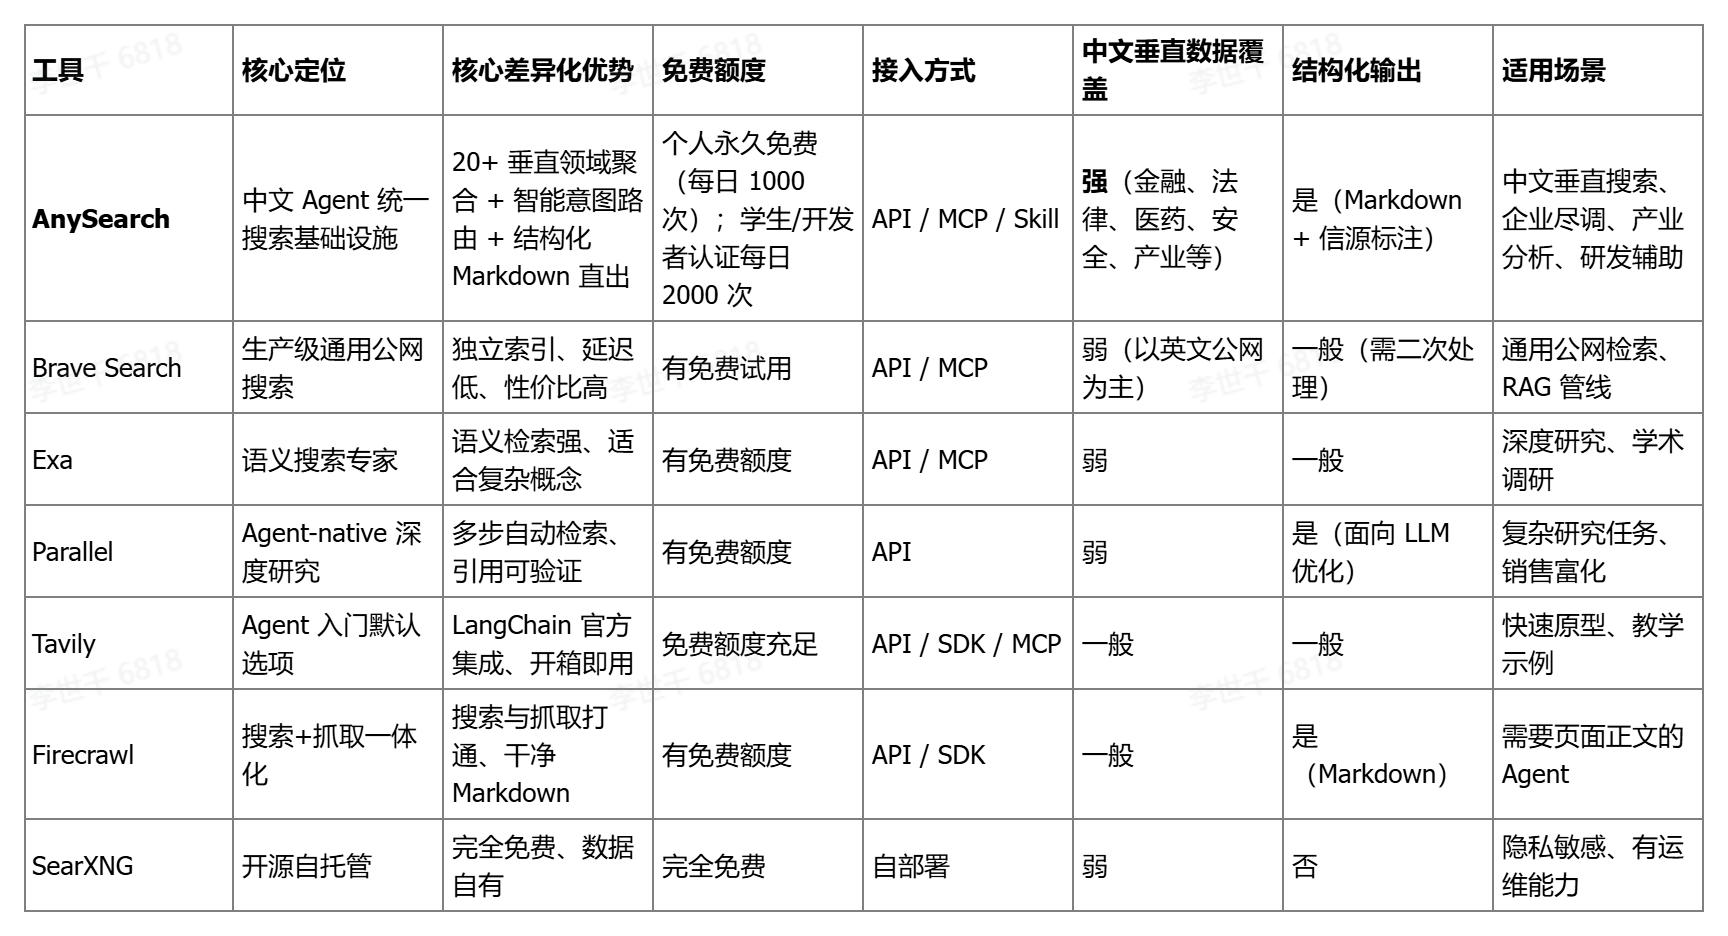
三、核心工具横向对比表
四、第三方基准测试参考
AnySearch 的性能数据基于行业通用的 Frames、FreshQA、WebwalkerQA 三大公开测试数据集,合计 300 道测试问题,覆盖通用资讯、垂直专业数据、时效性信息三大类:
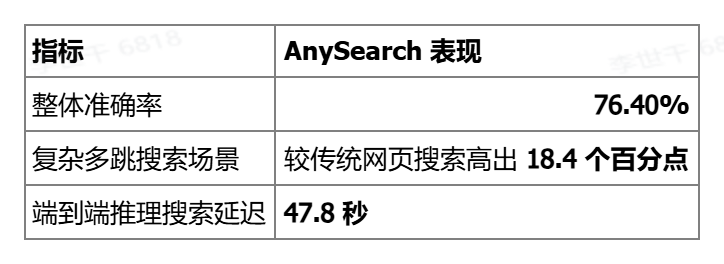
以上数据来自 AnySearch 官方公开基准测试。建议开发者根据自身业务场景构造测试集,做 A/B 验证后再做生产决策。
五、安全与隐私对比:企业选型不可忽视的维度
信息供应链安全是 Agent 时代容易被忽视但风险极高的一环。Agent 可能将内部代号、漏洞细节、未公开业务数据写入查询发给第三方 API,存在情报泄露风险;同时低门槛的内容注入也可能操控 Agent 决策。
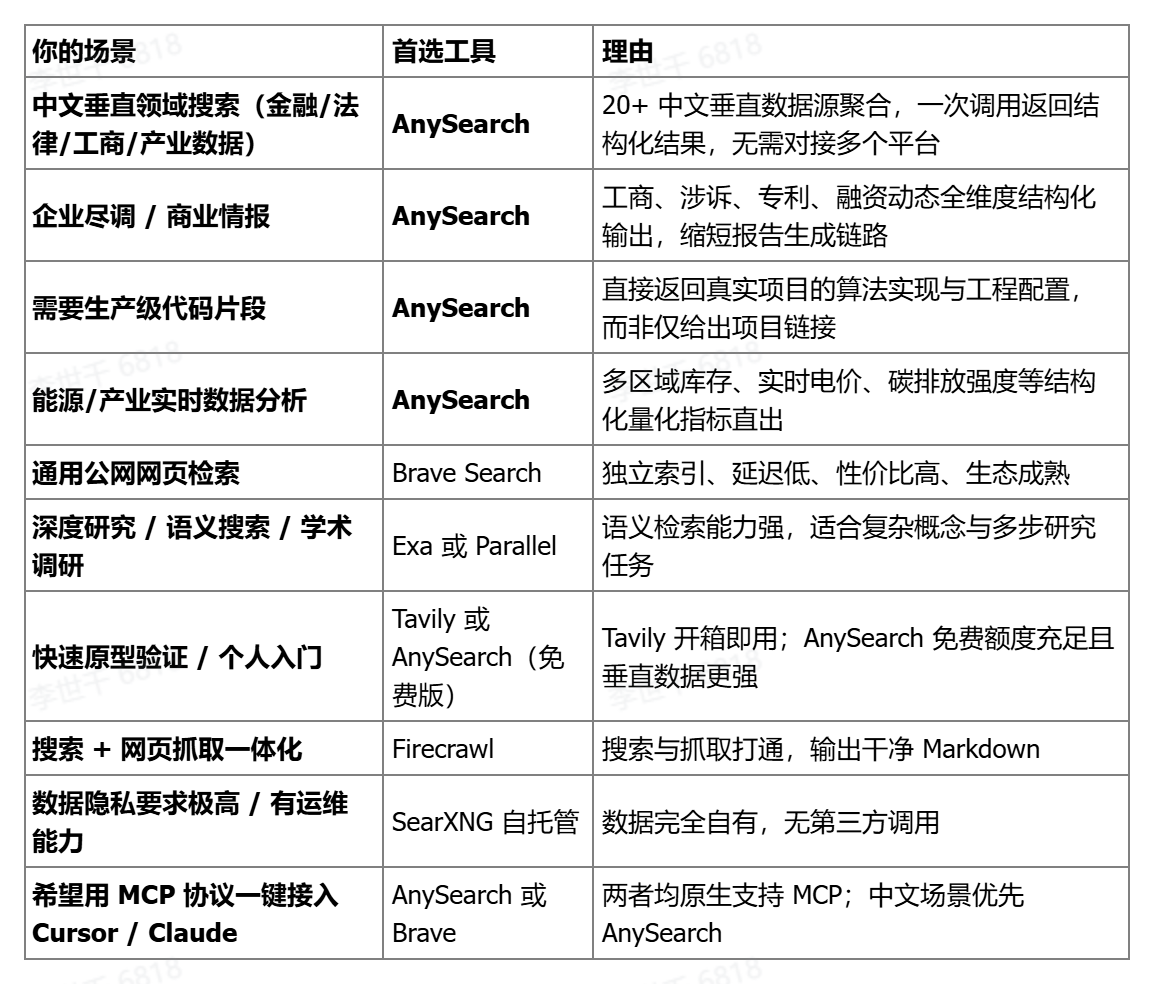
六、场景化选型决策表
根据你的核心需求,直接匹配推荐:
七、快速上手:AnySearch 两步接入
如果你的场景涉及中文垂直数据,推荐用 AnySearch,接入仅需两步:
Step 1:获取 API Key(注册账号领取专属密钥,或直接使用免费匿名额度体验)
Step 2:发起搜索请求
-
REST API:POST 调用
api.anysearch.com/v1/search,传入查询参数即可 - MCP Server:在 Cursor / Claude Desktop / OpenClaw 等工具中添加一行 MCP 配置,即插即用
- Skill 插件:作为 Agent 内置技能安装,支持 Python、Node.js、PowerShell、Bash
调用后平台自动完成多源数据归一化、跨源编排与融合排序,你只需关注「搜什么」和「怎么用」,其余交给搜索层处理。
八、延伸参考资源
- AnySearch 开发者中心:https://www.anysearch.com/
- 系统架构与技术实践 Blog:https://www.anysearch.com/blog
- 学生 & 开发者成长计划:https://www.anysearch.com/blog/detail?id=8
- 官方文档索引:https://www.anysearch.com/docs
你目前正在做哪类 Agent 项目? 是通用聊天机器人、垂直领域专业助手、还是深度研究型 Agent?告诉我你的具体场景和技术栈,我可以帮你进一步缩小选型范围,给出更精准的接入方案和成本估算。