
MongoDB亮相2026云栖大会,以AI原生数据平台为Agentic AI“减负”
9月22日至24日,2026云栖大会在杭州召开。本届大会以“Agentic AI”为核心锚点,串联起从芯片、云基础设施,到模型能力、模型服务,再到Agentic应用的完整技术链路,直指数字化生产力的深层变革。大会期间,举办3大主论坛、120场分论坛,设置智能、算力、创造、产业四大展馆,共5万平米,承载1000余家企业参展。会期迎接来自全球六大洲、80余个国家超过15万人次观众线下参会,超过8000万人次在线上收看。
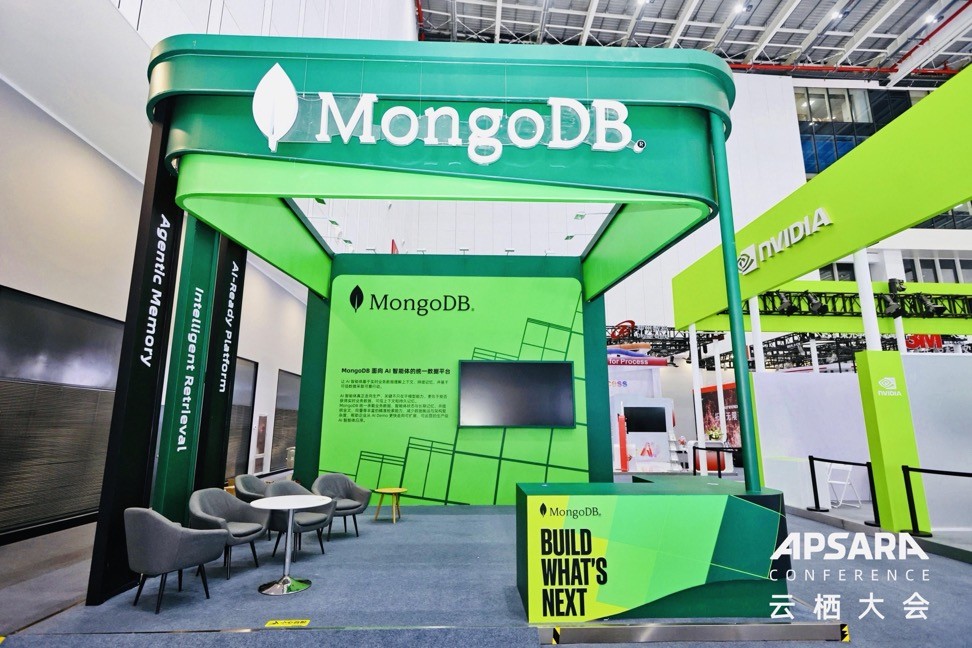
在大会的生态展区4-C15展台,MongoDB携原厂专家在现场为与会者传道授业解惑,与开发者面对面交流AI时代数据层的非常好的实践。
Agentic AI时代,数据层成为关键瓶颈
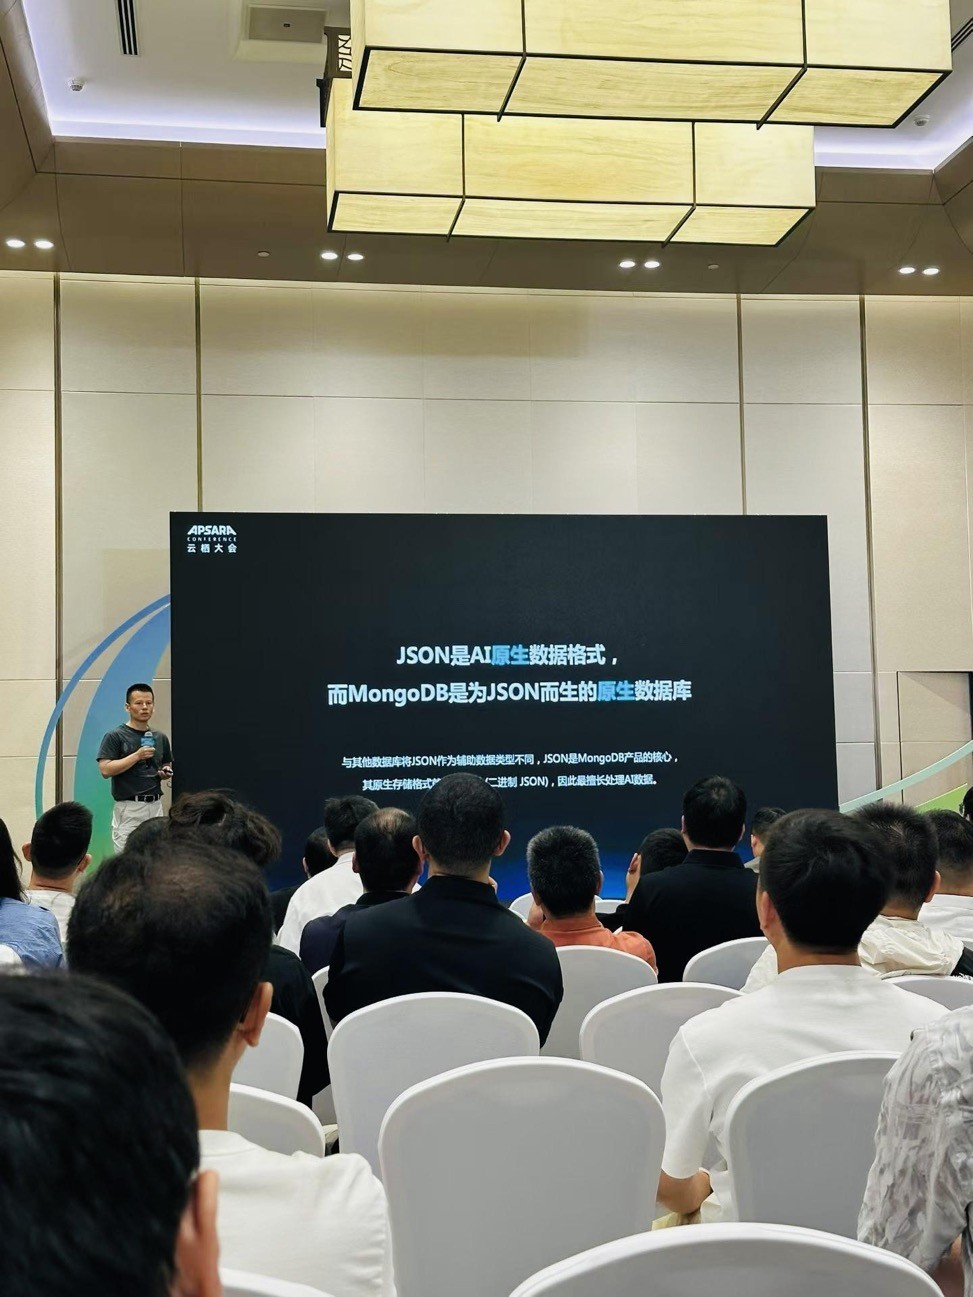
当Agent从Demo走向生产环境,真正的挑战并非模型本身,而是其背后的数据层。“数据层承载Agent所知、所记和所执行的内容,其实时性、准确性和事务能力直接影响Agent能否进入生产环境。”MongoDB高级解决方案架构师周斌在9月23日的“为Agent重构数据库:Agentic Database的架构与实践”专场中发表《AI Native Works——MongoDB为真实AI场景减负》主题演讲时指出。
这一判断正在成为行业共识。随着Agentic AI从概念验证进入规模化部署阶段,企业发现传统的“拼接式”架构——向量数据库、内存存储、事务数据库各司其职——不仅增加了运维复杂度,更在数据同步与实时性上形成瓶颈。
从文档数据库到AI Native引擎
MongoDB给出的答案是一体化的AI原生数据平台。周斌在演讲中介绍,MongoDB以BSON文档模型集成增删改查、事务、全文检索、向量检索、时序和地理空间等能力于同一平台,支持从多模态数据管理、混合检索到Agent记忆的完整应用链路。
阿里云智能集团数据库产品事业部付秋雷在《阿里云MongoDB:从文档数据库到AI数据引擎》的分享中,进一步区分了“支持AI”与“AI Native”的本质差异:前者是外挂向量模块或Embedding接口,后者则让AI能力原生长在引擎里,帮架构做减法。
围绕这一思路,阿里云MongoDB展示了三项核心能力:MongoDB Search将全文检索与向量检索集成到数据库内,数据和索引无需复制到外部系统;Auto Embedding对接主流模型自动完成向量化,省去“数据导出—模型处理—结果写回”的ETL链路;Agent Skill以自然语言辅助内存诊断、慢查询分析、索引优化与容量规划,降低运维门槛。
全球化部署与性能支撑
在AI应用走向全球化的背景下,数据基础设施的覆盖能力同样关键。MongoDB Atlas已覆盖全球117个以上区域,为企业部署全球化AI应用提供数据服务基础。与此同时,MongoDB 8.0与8.3持续优化读写吞吐,在性能层面为Agent工作负载提供支撑。
生态展台:专家面对面,答疑解惑
除了专场演讲,MongoDB在大会生态展区4-C15展台的亮相同样吸引了大量开发者驻足。原厂专家团队在现场为参会者提供一对一的技术咨询,围绕Agent记忆管理、混合检索架构、向量嵌入非常好的实践等话题展开深入交流。

一位在现场咨询的开发者表示:“我们正在构建一个跨会话的企业知识Agent,最大的痛点是如何在保持检索准确率的同时,不让架构变得过于复杂。MongoDB将向量、全文检索和事务能力整合在一个平台里,这正是我们需要的方向。”
让能力回归原生
“AI应用的理想架构不是堆叠组件,而是让能力回归原生。”付秋雷在演讲中总结道。这一理念与MongoDB在全球市场传递的信号一致:企业真正需要的,是一个能够在生产环境中稳定运行Agent的统一数据平台,而非又一堆需要缝合的技术组件。
随着Agentic AI从2026年的技术热词走向产业落地,数据层的选择将决定Agent能否真正“进入生产环境”。MongoDB在云栖大会上的亮相,给出了自己的答案。

