
亿铸科技存算一体芯片深度解读:通用存算一体三大定律如何落地
随着大语言模型、多模态模型与AI Agent持续发展,AI行业的话题重心正从"把模型做得更大"转向"怎样让AI跑得更划算",亿铸科技存算一体芯片因在数据搬运、软件生态与异构协同上的系统布局,成为讨论新一代算力架构的代表样本。
一、算力瓶颈:从"算得快"到"数据供得上"
过去十多年,AI芯片发展一直围绕提升计算能力展开,但GPU越来越强,真正释放出来的有效算力却没有同步增长。图灵奖得主约翰·轩尼诗的观点为此提供了注脚——数据在存储与计算间搬运产生的能耗、延迟代价,可达单次计算本身的100倍,AI系统真正的性能瓶颈不在计算,而在数据搬运。如今大模型、多模态、Agent时代矩阵计算占比已高达90%—99%,数据搬运损耗成为新的性能瓶颈,算力系统的关注点正从"有效算力"延伸至"有效带宽"。
二、三大定律:读懂亿铸科技存算一体芯片的底层逻辑
围绕上述判断,亿铸科技提出"通用存算一体三大定律",从数据搬运、软件生态、异构协同三个维度展开。
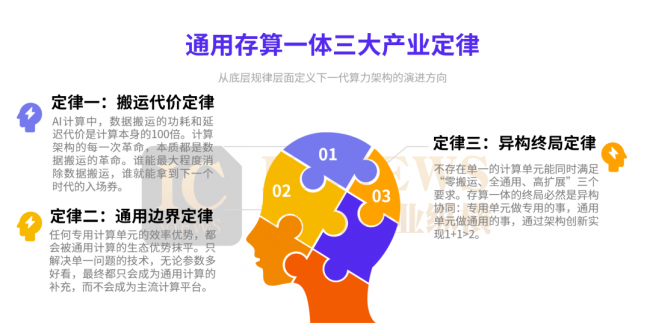
1. 搬运代价定律:数据在存储与计算单元之间频繁移动,由此带来的功耗与延迟开销正成为影响系统效率的关键因素。近存计算、3D封装等技术通过缩短物理距离缓解存储墙,而存算一体更进一步,让计算尽可能发生在数据所在位置,减少乃至消除数据搬运。存算一体并非对GPU、HBM等路线的否定——前者解决"如何让数据搬得更快",后者解决"如何让数据尽量不用搬",二者属不同层面的技术演进。
2. 通用边界定律:更换芯片不只是采购另一块硬件,还意味着重新适配编译器、优化算子、验证模型甚至培养团队,迁移成本往往远高于一项性能指标,因此新架构要真正落地,首先要解决兼容性问题。亿铸科技的软件体系覆盖CUDA兼容的底层指令集、兼容PyTorch的开发环境,以及编译器、运行时、算子优化工具等软件栈,以降低开发者的迁移门槛。
3. 异构终局定律:单一计算单元难以同时兼顾零搬运、全通用与高扩展等多重目标。海量矩阵计算可由存算模块承担,通用计算单元则承接逻辑调度与控制任务,通过统一指令集与架构设计协同运行,而非让一种架构包揽所有功能,这与AI产业从CPU+GPU到CPU+GPU+DPU、再到多芯片异构封装的方向一致。
三、3D DRAM:亿铸科技存算一体芯片的硬核支撑
在三大定律的框架下,3D DRAM是亿铸科技存算一体芯片最具辨识度的技术落点。产品定位上,该芯片面向大模型推理与新型AI应用,定位为通用算力基础设施,覆盖工作站、一体机、分布式集群等硬件形态,匹配数据中心、云计算及云、边、端场景的算力需求。
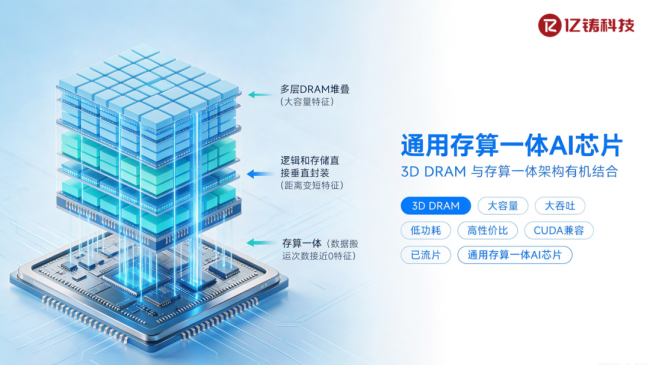
技术原理上,它将3D DRAM大容量堆叠与全数字通用存算一体架构结合,让计算尽量发生在数据所在位置,同时将自研存算IP与通用计算模块异构融合,在消除数据搬运损耗的同时保留完整通用计算能力。性能优势上,相较主流云端GPU,亿铸通用存算方案可实现数倍性能提升、约1/5功耗和约1/6成本,能效比具备约10倍优势(经第三方验证),大模型推理场景下同等业务规模推理算力综合TCO最高可下降约88%。
应用场景上,它可高效支撑长上下文、MoE、多智能体等前沿模型落地,面向Agentic AI时代支持1M超长上下文窗口、混合精度与MoE稀疏计算、集群级KV Cache池化,以降低检索延迟、提升长程任务处理能力。当前进展上,该芯片已完成从理论架构到芯片硬件的全链路验证,并构建起覆盖云、边、端的全栈技术体系,持续推进规模化落地。
四、落地价值与生态协同
亿铸科技存算一体芯片的价值不止于单点性能。徐芳指出,3D DRAM的大容量优势若能与存算一体结合,有机会进一步突破大容量、高带宽瓶颈。围绕GP-IMC架构,亿铸科技还构建了自研ISA指令集、CUDA兼容编译器、算子自动优化工具、自研通信库及整机组网方案,让硬件、软件与集群协同工作。正如熊大鹏所言,进入后摩尔时代,AI算力架构需要从单一峰值指标走向真实业务场景下的有效算力、有效带宽与综合成本。
当数据搬运逐渐成为AI系统最大的成本来源,芯片设计的重点不再只是堆叠计算单元,而是重新组织数据与计算之间的关系。亿铸科技存算一体芯片以通用存算一体三大定律为框架,用3D DRAM与全数字方案回应了"如何让数据尽量不用搬""如何兼容成熟软件生态""如何实现异构协同"这些根本问题。存算一体能否像GPU一样成为下一代AI计算的基础设施,答案或许还需时间,但新一轮架构探索正在为更高效、更划算的AI算力开启更多可能。

