
SenseNova Loop-9B 正式版:让更少的参数走更深的计算路径
商汤科技正式发布 SenseNova Loop-9B。该模型延续了 Preview 版本对参数效率的探索:通过 Loop 结构复用模型层的参数,并结合流形约束超连接(mHC),在约9B参数规模下扩展计算深度,面向复杂推理、代码、工具调用和多模态任务。模型得益于 Loop 的高效循环结构,官方 4bit 量化后权重仅约 4.9GB,部署显存需求低至 10 GB内,能显著拓宽可部署的硬件范围,让低显存芯片获得前沿 27B 级别模型性能成为可能。
Preview 发布以来,我们收到了社区对模型使用、推理部署和生态适配的关注与反馈。此次正式版沿用 Loop 与双流 mHC 架构,进一步优化模型在 Agent、代码与数据分析任务中的表现,并继续探索循环计算在模型能力提升中的作用。
SenseNova Loop-9B 总参数量约为 9B。模型通过两次执行共享的中间层,将 32 个物理解码层扩展为 56 次层计算;支持文本、图像输入和文本输出,上下文长度最高可达512K tokens。在 Agent 与数据分析评测中,模型展现出与 Qwen3.8-27B 相当的竞争力:NL2Repo 得分为 41.36,接近后者的 44.60;AIDABench 得分为 65.31,高于后者的 65.01。
模型亮点
• 共享循环模块:将第 4–27 层组成共享权重的循环模块,并执行两次,使模型在一次前向传播中完成 56 次解码器层计算。 • 双流 mHC:通过可学习映射,对循环模块中的两条残差流进行信息路由与融合。 • 混合注意力:解码器以四层为一组,采用三层线性注意力与一层全注意力相结合的配置。 • 长上下文多模态:训练方案覆盖文本、图像、代码和工具调用轨迹,上下文长度最高扩展至 512K tokens。 • 低资源私有化部署友好:采用 4bit 权重量化与 8bit KV 缓存时,256K 长上下文推理的显存需求约为 15 GiB,有助于降低本地与私有化部署门槛。 • 官方量化版 Day 0 提供:模型发布首日同步提供官方AWQ 4bit 量化版本,方便用户快速部署。
SenseNova Loop-9B 已开放模型权重与相关代码,供开发者和研究者下载、部署与探索。
模型能力:正式版较 Preview 进一步提升
我们围绕通用 Agent、代码和数据分析等任务,对 SenseNova Loop-9B 正式版进行评测,并与 Preview 版本及Qwen3.8-27B 等模型进行比较。
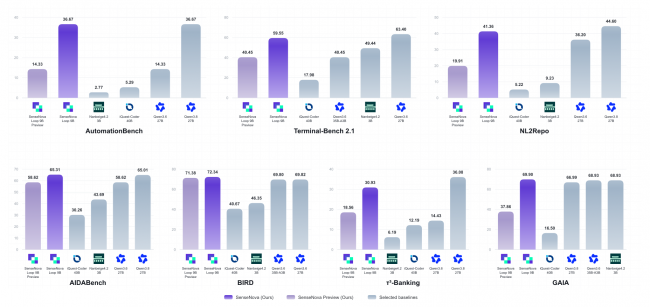
评测结果显示,SenseNova Loop-9B 正式版在多个榜单上的表现较 Preview 版本有明显提升;并在约 9B 参数规模下,展现出与 Qwen3.8-27B 比肩的性能表现。
模型表现
以下是 SenseNova Loop-9B 正式版在实际场景中的表现。(注:下方 Showcase 均由本模型在 Codex / Hermes 中,经 1–4 轮用户交互完成。)
制作《失真频率 DISTORTION FM》音乐节动态海报网页
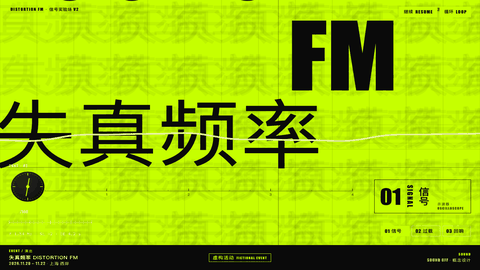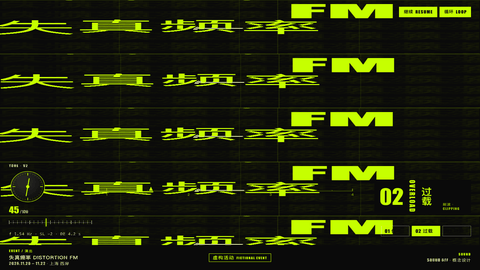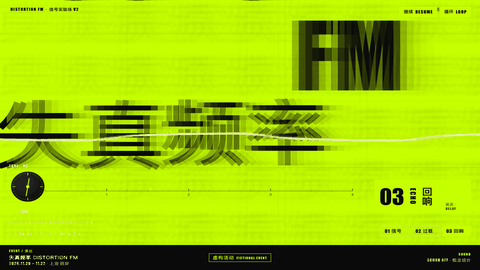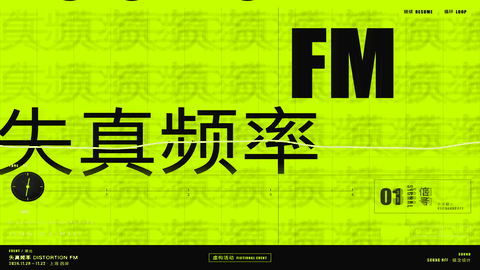
Prompt:制作《失真频率 DISTORTION FM》音乐节动态海报网页。巨大窄体标题占据画面,酸橙绿、黑、暖白三色;字体挤压、错位、重组,背景文字前移遮挡后揭示新章节。点击三个演出章节切换有节奏的全屏构图,提供循环及暂停。小字号中文演出信息清晰,虚构活动标注概念设计。参考 @url:https://tympanus.net/Development/KineticTypePageTransition/ 的文字转场概念,原创实现。
制作「字形接力 TYPE RELAY」的实验字体展交互网站
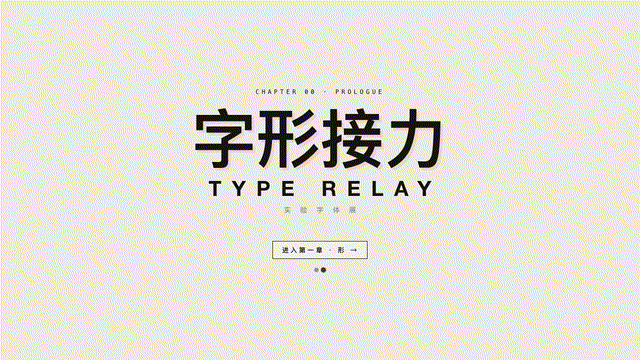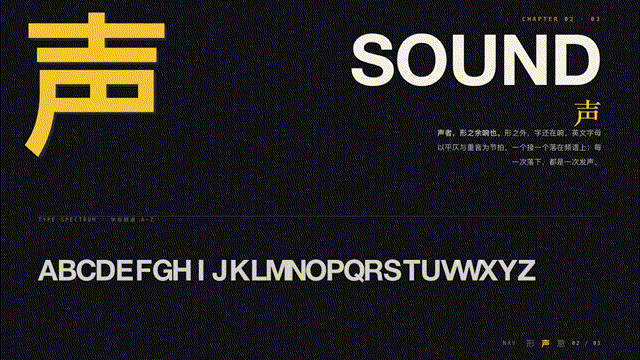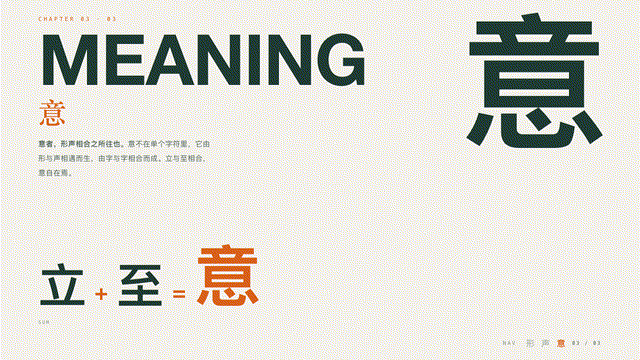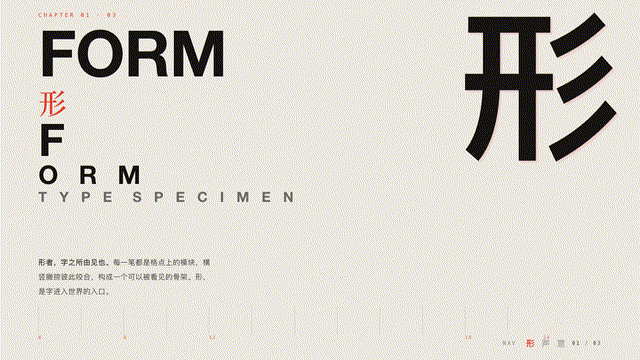
Prompt1:制作一个名为「字形接力 TYPE RELAY」的实验字体展交互网站。让文字本身成为页面切换的主角:用户在「形」「声」「意」三个展览章节之间切换时,巨大的汉字与英文字母通过有节奏的移动、尺度变化和重新编排,把上一章自然带入下一章,像一场连续的字体表演。每章有自己的内容、色彩和构图,既有鲜明的实验性,也保留清晰的阅读层级。请自行设计原创视觉语言、转场编排和交互细节,做出可在浏览器实际操作的完整网页。
Prompt2:请按下面这版详细要求继续制作《字形接力》,细化视觉与转场:
制作原创实验字体展网站「字形接力 TYPE RELAY」,包含「形、声、意」三个可切换章节。核心体验是一场由巨大文字驱动的整屏转场,具有先锋平面设计和动态字体短片的质感。
每个章节都要有完整且不同的构图:超大中英标题、简短展览文案、具有视觉张力的主图或原创图形,以及精简导航。用鲜明的字号对比、局部出界裁切、不对称布局和准确留白建立层次,具体配色与字体组合由你设计。
点击章节后的转场分三个阶段:
1. 当前内容短促退场,章节关键词迅速放大,同一个词形成多行排印,逐渐铺满屏幕。
2. 各行文字以错开的时序和不同方向掠过画面,形成有节奏的遮挡;背景色同步接管画面,在遮挡最充分时完成章节切换。
3. 字阵继续运动并退出,新章节的主标题、主视觉和说明依次显露,最后稳定在清晰可读的版面。
转场约 1.5–2 秒,有明确的蓄势、加速和收束,避免匀速滑动。文字的运动轨迹、行距、尺度和前后层次要经过编排,既能感到强烈冲击,也能看出秩序。切换过程中保持画面连续,下一章不要突然闪现。
三个章节共享一套视觉语言,但分别体现结构、节奏和留白的差异。支持前后切换,连续点击时妥善处理动画状态,窗口尺寸变化后仍保持完整构图。直接制作可在浏览器操作的网页。
制作《海岸线以外》摄影杂志式HTML短篇网页
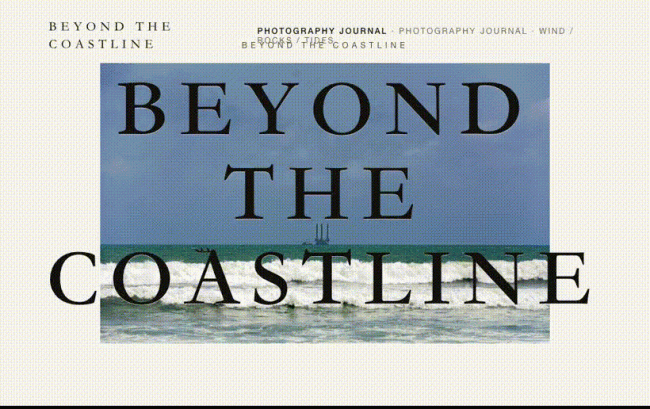
Prompt:制作《海岸线以外》摄影杂志式HTML短篇网页。米白与墨黑,巨大衬线字、克制中文说明、真正的高质量海岸照片。开场海景嵌在字缝中,滚动展开为全屏,再连续进入风、礁石、潮汐三个章节;图文之间有精确留白和滚动节奏。参考 tympanus.net/Development/ImageExpansionTypography 的图文展开关系。可用合法公开图片并保存本地、注明来源;不要用渐变色块冒充摄影。
模型结构
SenseNova Loop-9B 以 32 层多模态解码器为基础,将共享权重的循环计算、混合注意力和双流流形约束超连接(mHC)结合在一起。模型通过复用中间层参数扩展计算深度,支持文本与图像输入、文本输出,并支持最长 512K token 的上下文。
模型规格
| 项目 | SenseNova-Loop-9B |
|---|---|
| 架构 | 自回归多模态解码器;循环模块采用双流 mHC |
| 参数规模 | 总共约 9B 参数,推理等效参数规模约 14.6B |
| 输入 / 输出 | 文本和图像 / 文本 |
| 独立解码器层数 | 32 |
| 循环层范围 / 执行次数 | [4, 28) / 2 次,共享权重 |
| 解码器层执行次数 | 每次前向传播执行 56 次 |
| mHC 残差流数量 | 2 |
| 上下文长度 | 512K tokens |
| 权重精度 | 主干为 BF16;mHC 路由参数为 FP32 |
循环解码器
输入首先经过第 0–3 层,随后依次通过同一组第 4–27 层两次,最后由第 28–31 层和输出头生成模型输出。若用 B 表示循环模块、h 表示其输入,则循环计算可写为 B(B(h))。
推理时,模型每次前向传播完成 56 次解码器层计算,只需存储 32 层解码器权重。循环模块在两次执行中复用同一组权重,第二次执行以第1次的输出作为输入。
混合注意力
解码器交替使用线性注意力层与全注意力层。每四层为一组,依次包含三层线性注意力和一层全注意力。循环模块的边界与完整的四层组对齐,因此两次执行都保持相同的注意力排列。
双流 mHC
在循环模块中,mHC 使用两条残差流传递解码器层计算前后的信息。可学习映射决定各层如何读取残差流、混合流间信息,以及将层输出写入残差状态。流间混合映射采用 Sinkhorn 归一化进行约束;模型配置使用 20 次迭代。
可以将两条残差流理解为并行传递的两组隐藏状态:每个循环层先从残差流读取信息,执行注意力或前馈计算,再把结果写回。流间混合矩阵通过反复进行行、列归一化,约束信息在两条流之间的混合;这 20 次归一化迭代属于 mHC 内部计算,与循环模块执行两遍是不同的步骤。
循环层范围、执行次数和 mHC 路由参数共同构成模型检查点的执行配置。兼容的推理实现需要加载这些参数,并保持相同的计算顺序。
| 配置 | 数值 |
|---|---|
| 独立解码器层数 / 执行次数 | 32 / 56 |
| 循环层范围 / 执行次数 | [4, 28) / 2 |
| 隐藏层维度 | 4,096 |
| 前馈网络维度 | 12,288 |
| 词表大小 | 248,320 |
| 全注意力头数 / KV 头数 | 16 / 4 |
| mHC 残差流数量 / Sinkhorn 迭代次数 | 2 / 20 |
Loop Scaling:探索循环计算的收益
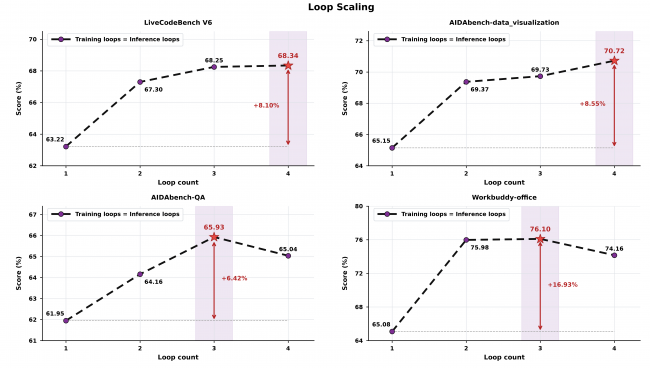
Looped Transformer 展现出良好的性能扩展潜力,为模型能力提升提供了循环计算这一新的探索维度。以原版 9B 模型(即图中对应标准单次前向计算的 Loop 1)为基准,我们在保持训练数据等配置一致的条件下,探索了循环计算的 Scaling 效果。实验结果表明,随着训练与推理循环次数的同步增加,模型在四项核心任务上的表现均呈现出上升趋势。具体而言,AIDAbench-QA 和 Workbuddy-office 任务在 3 次循环时表现最佳,较 9B 基准分别提升了 6.42% 和 16.93%;而在 LiveCodeBench V6 和 AIDAbench-data_visualization 任务中,4 次循环则进一步推高了模型表现,分别实现了 8.10% 和 8.55% 的性能增长。
综合考虑实际应用中的推理效率,我们当前的 Preview 和正式版模型均默认采用 2 次循环。然而,深层循环所带来的性能增益依然客观存在。以代码生成(LiveCodeBench V6)和数据可视化(AIDAbench-data_visualization)这两项较为复杂的任务为例,若将循环次数从当前的 2 次增加至 4 次,模型得分仍能分别获得 1.04 和 1.35 个百分点的提升。这一结果印证了 Loop Scaling 的有效性,也表明当前的 1 到 4 次实验只是一个起点,更高循环深度所蕴含的能力空间仍值得进一步挖掘。
此外,上述实验结果也直观地反映出,不同类型任务对循环深度的需求存在显著差异。基于这一观察,在后续的研究中,我们不仅会继续探索更高循环深度的能力边界,还将重点研究动态循环(Dynamic Loop)架构。该架构旨在让模型能够根据输入任务的复杂程度,自适应地匹配最优的循环次数,从而在确保复杂任务获得充分算力的同时,兼顾整体的推理效率。
低显存硬件部署友好
得益于 Loop 的循环共享结构,模型仅需约 9B 独立参数,4bit 量化后权重体积仅约 4.9GB,显著降低本地与私有化部署的硬件需求门槛。结合 8 比特或 4 比特 kv 缓存,可进一步降低长上下文推理的显存需求,不同 kv 量化粒度下,模型部署最低显存需求如下表所示:
| 上下文长度 | 8bit kv | 4bit kv |
|---|---|---|
| 64K | 约 10 GiB | 约 9 GiB |
| 128K | 约 12 GiB | 约 10 GiB |
| 256K | 约 15 GiB | 约 12 GiB |
当前不足与持续改进
尽管 Loop Transformer 架构已经展现出很大的潜力,但是受限于模型体量和迭代时间,SenseNova Loop-9B 在以下方面仍有改进空间:
• 面对较多、较复杂的工具定义或多重条件约束时,模型仍可能出现理解与执行偏差,影响任务表现。 • 代码能力虽较 Preview 明显提升,已具备较好的可用性,但在代码和通用 Agent 任务中表现稳定性还存在不足,但是模型可以通过更多步骤修正自己的错误。整体而言,处理复杂长程任务的能力还需要持续打磨。 • 包含复杂 3D 场景和丰富动态元素的高质量网页,未必能单轮完成,部分案例需要结合用户反馈,经过 2–3 轮修复才能达到较好的效果。
我们将持续补强上述局限,并计划在未来把 Loop 架构应用于更大规模的模型,争取以更高频的模型更新回应真实使用中的需求,也欢迎社区分享使用反馈、问题案例与改进建议。
快速开始:使用SenseNova Loop-9B
模型权重与相关代码现已开放。开发者可通过 Hugging Face 模型仓库或本地模型目录加载模型。
• Hugging Face 仓库:https://huggingface.co/collections/sensenova/sensenova-loop
下方示例展示了单张 GPU 上的文本生成,以及使用推理引擎启动服务的方法。
环境要求
Preview 版本已验证的环境为 Transformers 5.18.0、PyTorch 2.11.0 和 CUDA 13.0。模型目录需要包含配置、分词器、对话模板、自定义模型代码和全部权重分片。
请先安装与 CUDA 环境兼容的 PyTorch,再安装其余依赖:
| bash python -m pip install "transformers==5.18.0" accelerate safetensors |
|---|
使用 Transformers 生成文本
将 model_id 替换为正式版模型目录或模型仓库 ID,然后运行以下代码:
| python import torch from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "/path/to/SenseNova-Loop-9B" device = "cuda:0" tokenizer = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True) model = AutoModelForCausalLM.from_pretrained( model_id, trust_remote_code=True, dtype=torch.bfloat16, device_map={"": device}, ).eval() messages = [{"role": "user", "content": "13 乘以 7 等于多少?"}] prompt = tokenizer.apply_chat_template( messages, tokenize=False, add_generation_prompt=True, enable_thinking=True, ) inputs = tokenizer(prompt, return_tensors="pt").to(device) with torch.inference_mode(): outputs = model.generate( **inputs, max_new_tokens=512, do_sample=False, use_cache=True, ) response = tokenizer.decode( outputs[0, inputs.input_ids.shape[1]:], skip_special_tokens=True, ) print(response) |
|---|
示例默认开启思考模式,使用贪心解码,最多生成 512 个新 token。将 enable_thinking 设置为 False 可关闭思考模式;修改 device 可指定使用的 GPU。trust_remote_code=True 用于加载 SenseNova-Loop 的自定义模型实现。
模型部署
以下命令参考 Preview 的部署示例,使用时请将模型路径替换为正式版权重目录;正式版对应的引擎版本与配置随发布更新。
LightLLM
以下为使用四张 GPU 进行部署的示例:
| bash docker pull ghcr.io/modeltc/lightllm:main docker run --rm --gpus all --ipc=host -p 8000:8000 \ -v /path/to/SenseNova-Loop-9B:/model \ -e LOADWORKER=4 -e LIGHTLLM_TRITON_AUTOTUNE_LEVEL=1 \ ghcr.io/modeltc/lightllm:main \ python -m lightllm.server.api_server \ --model_dir /model --model_name SenseNova-Loop-9B \ --tp 4 --host 0.0.0.0 --port 8000 |
|---|
服务启动后,可通过 OpenAI 兼容接口发送请求:
| bash curl http://localhost:8000/v1/chat/completions \ -H 'Content-Type: application/json' \ -d '{"model": "SenseNova-Loop-9B", "messages": [{"role": "user", "content": "Hello!"}], "max_tokens": 128}' |
|---|
SGLang
请使用包含 SenseNova Loop 实现的 SGLang PR #47281 对应版本,并替换模型路径:
| bash git clone https://github.com/sgl-project/sglang.git cd sglang git fetch origin pull/47281/head git checkout -b sensenova-loop FETCH_HEAD python -m pip install -e ./python sglang serve --model-path /path/to/SenseNova-Loop-9B |
|---|
vLLM
请使用包含 SenseNova Loop 实现的 vLLM PR #64832 对应版本,并替换模型路径。该 PR 当前仅支持未量化的文本推理,不对应上文的 AWQ 4bit 低显存配置:
| bash git clone https://github.com/vllm-project/vllm.git cd vllm git fetch origin pull/64832/head git checkout -b sensenova-loop FETCH_HEAD python -m pip install -e . vllm serve /path/to/SenseNova-Loop-9B \ --served-model-name sensenova_loop \ --tensor-parallel-size 4 \ --dtype bfloat16 |
|---|

