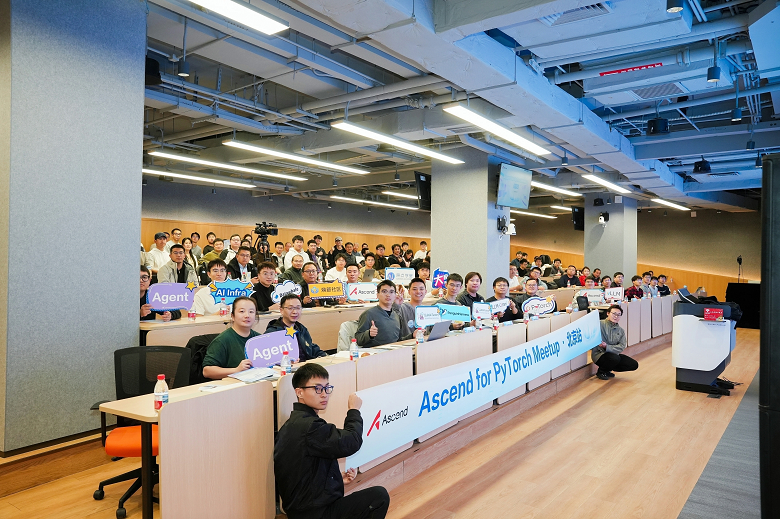
开源,让智能加速——Ascend for PyTorch Meetup北京站
11月7日立冬,Ascend for PyTorch联合 PyTorch、vLLM、vLLM-Omni、OpenBMB、LLaMAFactory、FlagOS 与 PenguinHarness 等社区相聚北京,与社区开发者、企业工程师、技术专家和学生一起,聊技术,也聊生态。
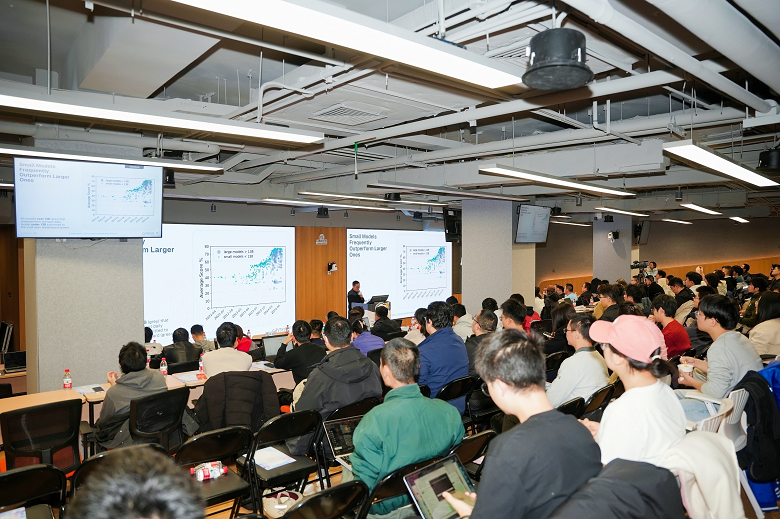
【活动现场全景】
活动伊始,主持人表示:开源正在加速 AI 进化,昇腾与 PyTorch 作为底层基础设施,将持续与开源伙伴、开发者交流互动、听取建议,一同共创 AI 新时代。
01 开源,让生态共生
Linux 基金会中国区总监、PyTorch 基金会亚洲区总监李昊阳以《Accelerating Open Intelligence Together》复盘北美 PyTorch Conference 的前沿观点。他指出,AI 行业正告别单纯堆砌硬件算力的“蛮荒时代”,聚焦场景、面向业务的小模型与在岗训练(On the Job Training)成为新趋势;开放权重模型、开源基础设施、全球共建生态三大支柱,正共同驱动开放智能加速演进。PyTorch 基金会也在持续推动开源组件跨芯片、跨云部署,助力国内多样化算力生态协同发展。他同时感谢昇腾社区在 PyTorch 社区建设与开源生态上的持续投入。
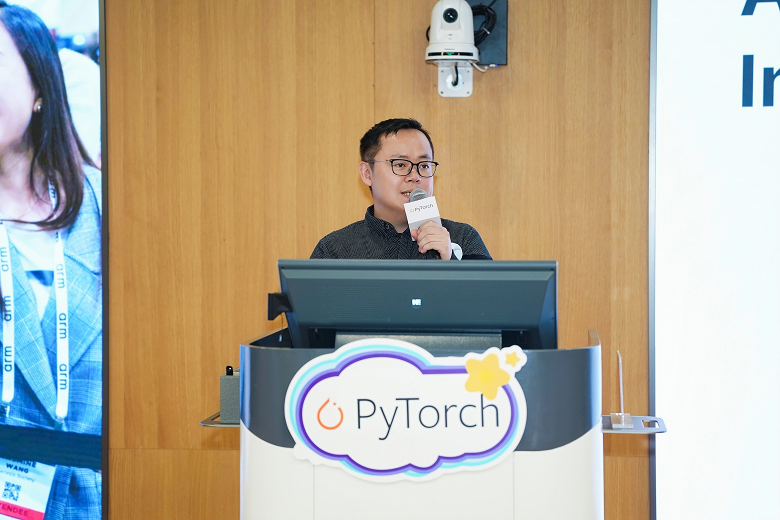
【李昊阳,Linux 基金会中国区总监、PyTorch 基金会亚洲区总监】
随后,PyTorch Maintainer 李佳伟以昇腾为例,介绍 PyTorch 多后端小组如何配合硬件厂商,做到“接得进来、质量有底、跟得上发版”。他提到,昇腾是首个进入 PyTorch 官网的中国硬件,也希望更多硬件能沿这条路径快速融入 PyTorch 生态。
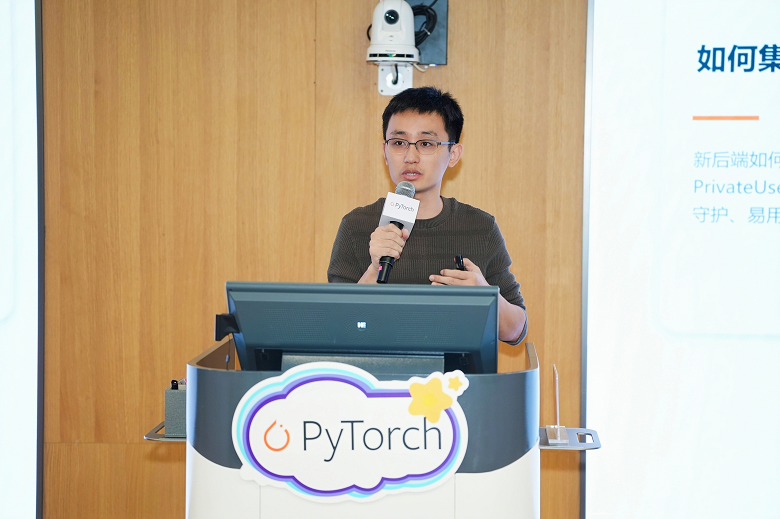
【李佳伟,PyTorch Maintainer】
Ascend for PyTorch Maintainer 王嘉霖则解释了多后端建设如何缩短昇腾的适配周期,让团队把精力回到核心技术本身,并分享了 TorchNPU 在分布式训练中的成果。面对模型参数持续膨胀与超节点架构的出现,TorchNPU 从建链、通信、显存与故障四个方向做了系统优化:分层建链化解单点瓶颈,对称内存支持卡间直接读写,多流内存复用减少等待,Watchdog 与 torch FT 把断点续训推向无中断训练,让大规模训练任务真正跑得下去。
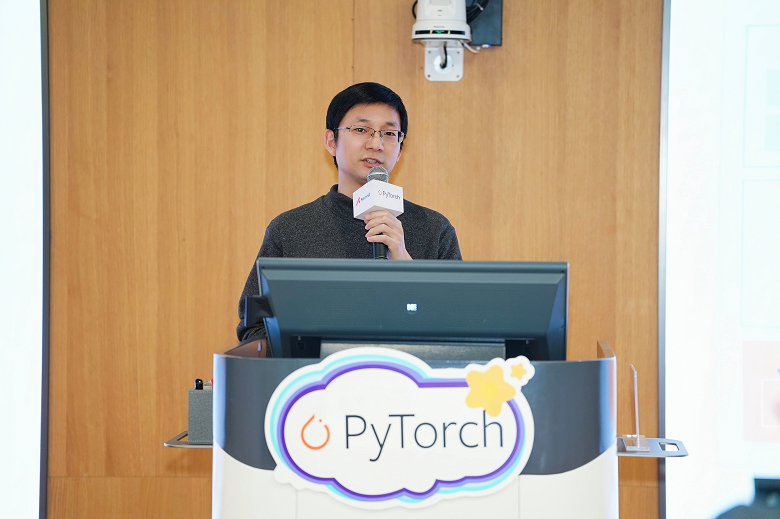
【王嘉霖,Ascend for PyTorch Maintainer】
02 开源,让产业加速
AI 短剧爆火,多模态需求随之激增。在一片“谁的生成速度更快”的竞速声中,vLLM-Omni 汪志鹏把目光从速度上移开,转回到真实需求:绝大多数场景,是用图像、视频、音频作参照去生成。于是 vLLM-Omni 围绕续写、局部编辑、时间戳关键帧与 ControlNet 重做了推理链路,用 Latent Cache 让续写的画面连声音都接得上,并把这套能力装进开源的 OpenDirector。他的判断很直接:推理引擎不该只回答“多快”,还得回答“能不能用”。
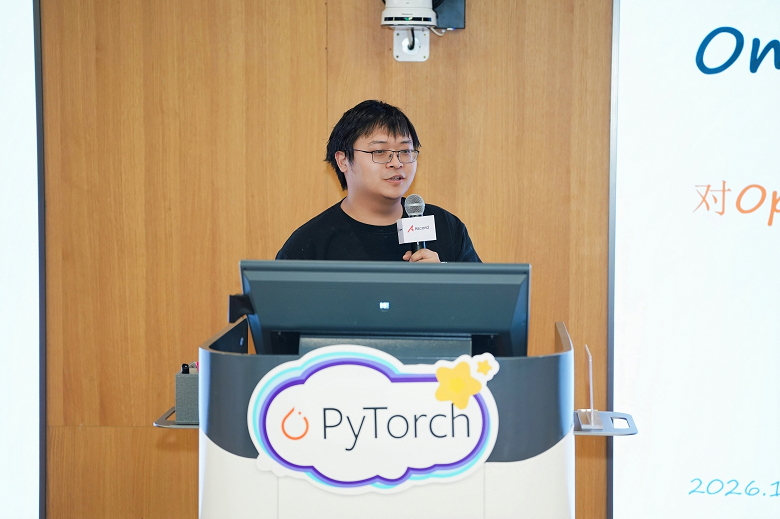
【汪志鹏,PyTorch基金会大使 vLLM-Omni,veRL-Omni,Vime Maintainer,MTS@Inferact】
面对端侧设备的算力与内存生产即固定。面壁智能蔡天驰走的是另一条路——让模型不必全住在内存里。35B-A3B 的 MoE 每层256个专家只用到8个,于是他们把专家权重放进闪存、按需换入换出;真正的耗时不在计算,而在 I/O 链路的系统开销,他们便用下一层 Router 提前预测要读的专家,让读取与计算互相掩盖,真用时还有一次复核机会,再按专家重排存储、做分层量化,把手机上2到3 token/s 推到 15 token/s,并把推理引擎与 APP 代码全部开源。
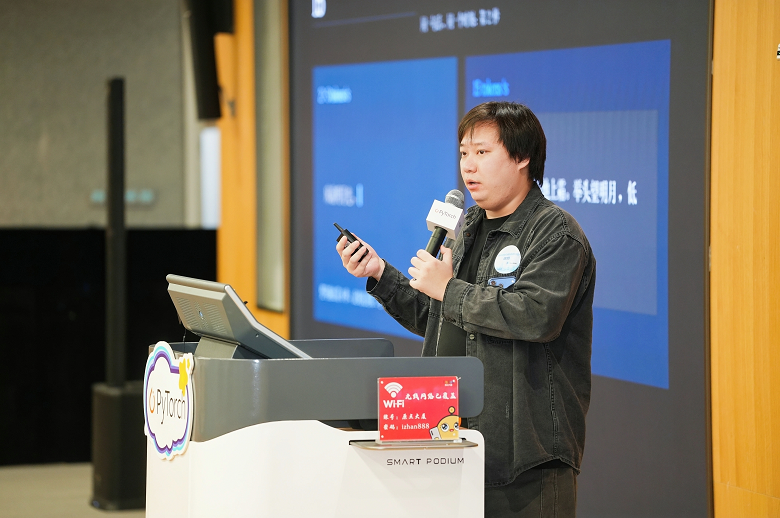
【蔡天驰,面壁智能多模态大模型实验室 算法研究员】
03 开源,让技术突破
递归自我改进正成为 Agent 领域的热门方向,而要不要为它专门造一套框架,业内仍在争论。LLaMA-Factory 作者郑耀威判断:任何 Harness 都能做自进化,差别只在能否把实验结论持续沉淀下来。他的落点在 Harness 本身——让它能被 Agent 改写。于是 PenguinHarness 把 Session、Prompt、Skills 与 MCP 全部落成文件,让 Agent 像改代码一样修改自己;用 A2App 渲染出按 Agent 隔离、可热插拔的工作台;再以 Multi-Agent 并行评估、七个内置工具与前缀缓存压低进化成本,并用 Docker 隔离、权限控制与全流程 traces 守住稳定。在他看来,自进化缺的从来不是新算法,而是一个能把实验结论沉淀下来的底座。
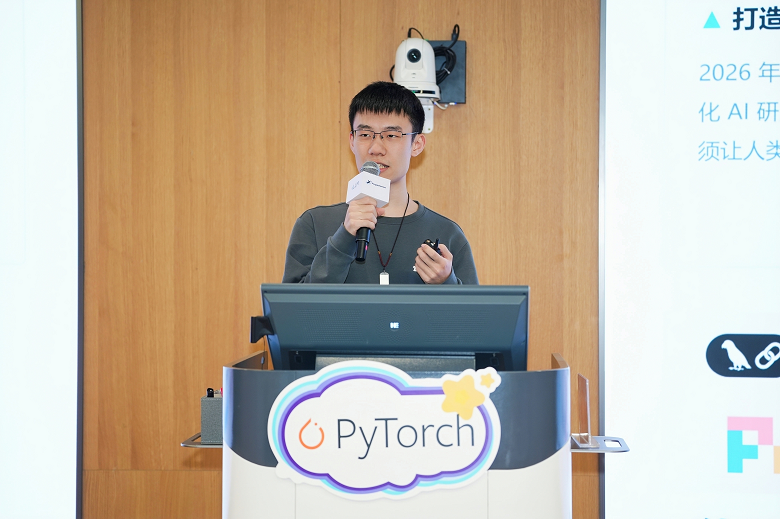
【郑耀威,LlamaFactory 作者、PrismShadow 创始人/CTO】
算子层的挑战则来自另一种复杂:算力多元、芯片各异,同一套模型往往要为不同硬件重复适配。智源王楷泽带来的是 FlagOS——以 FlagGems 为核心的跨芯片统一算子层,对标 PyTorch 的 ATen,只需一行代码,1400多个算子就能跑在20多款 AI 芯片上,接入 PyTorch 同样极简。在昇腾上,他把 TLE 的 light、strict、raw 三层写进同一个 Triton function,一路控制到 NPU IR;也优化了模型中的 Recurrent KDA(Kimi Delta Attention)算子,把40个 core 拆成8个生产者、32个迭代者,TPOT 降低3%到4%。
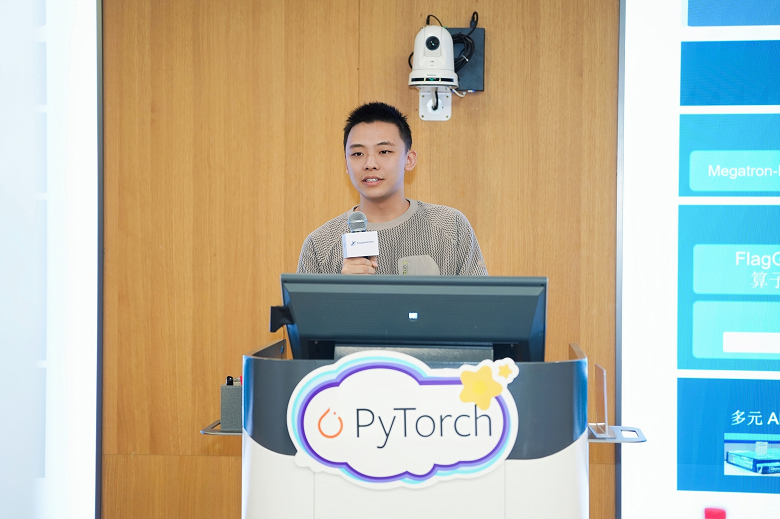
【王楷泽,智源 FlagOS工程师】
04 开源,让更多人参与进来
如果说上午回答的是“技术往哪走”,下午的三场分场回答的是“开发者怎么参与进来”。
AI Infra 研讨会由各社区 Maintainer 与专家坐镇,会前通过社区讨论区公开征集问题,现场与开发者面对面拆解训练、推理、多后端适配中的具体难题,并同步社区进展,鼓励开发者参与社区贡献与治理。
PyTorch 贡献 Workshop 由昇腾专家带着开发者走完第1次提交的全流程——从认领一个 Issue,到分支、编码、CI、评审,再到合并;同时开放30个社区任务的领取,把“第1次贡献”做成可交付、可验证的成果。值得一提的是,昇腾为 PyTorch 贡献场景专门设计了一系列 Skill,把仓库结构、编码规范、测试要求与 PR 流程这些原本靠“人带人”的经验固化下来,让新贡献者不必先花几周啃规则就能上手。
Agent Workshop 则由郑耀威带队,用 PenguinHarness 做完整实操,现场跑一遍“定义评估基准—Agent 自迭代—生成工作台”的闭环,让自进化从演讲里的概念变成可复现的操作。
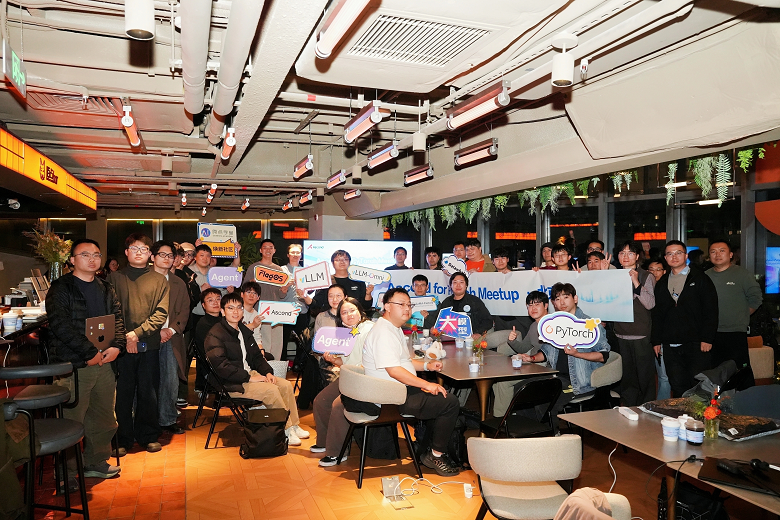
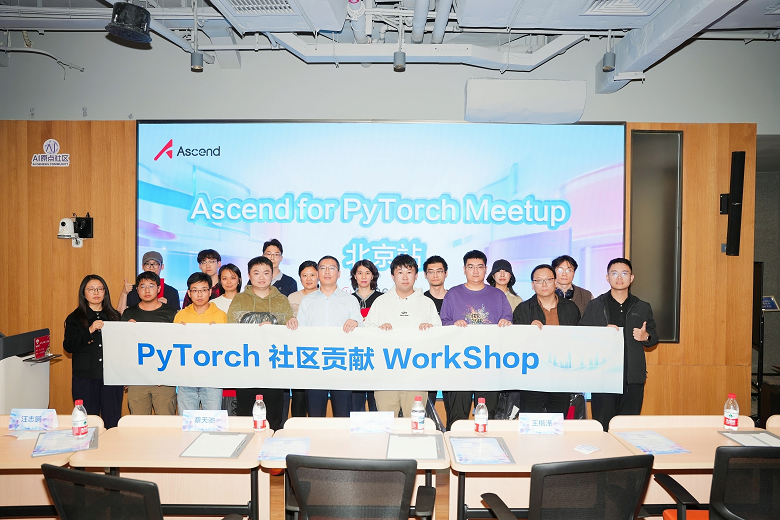
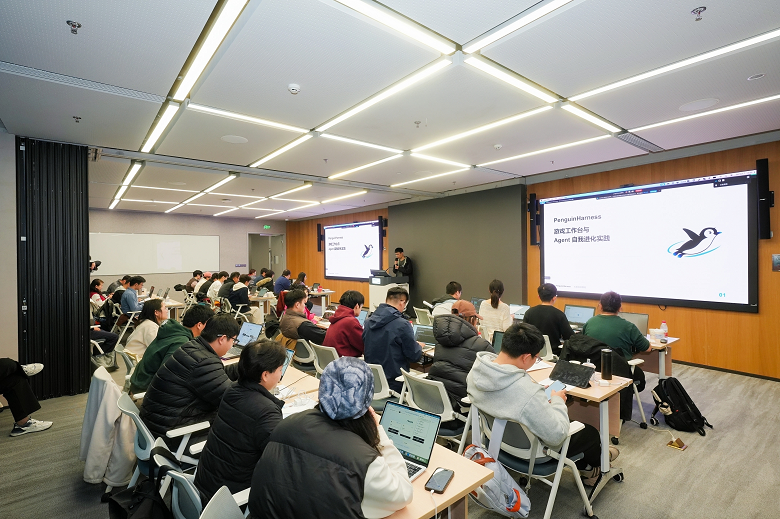
【下午三场分场现场】
从PyTorch的开放共识,到多后端与分布式的上游共建;从多模态推理、端侧部署的场景化重构,到 Agent 自进化与算子层的跨芯片统一,本次 Meetup 呈现出一条清晰的路径:昇腾正从“适配者”走向“共建者”,而开源社区也把效率、成本与真实需求重新放回了技术演进的中心。开源的意义正在于此——它既让技术跑得更快,也让更多人有机会参与进来。